Ces derniers temps, je me suis vraiment passionné pour l'exécution locale de grands modèles de langage (LLM), et après avoir vu tous les Des choses intéressantes que vous pouvez faire avec les outils MCPJe me suis rendu compte qu'il était temps de modifier un peu mes propres paramètres.

Au départ, j'ai succombé à l'engouement suscité par DeepSeek R1 lors de sa sortie, mais depuis, de nombreux nouveaux modèles ont vu le jour. Face à cette évolution rapide, j'ai jugé judicieux d'optimiser également mon flux de travail.
Liens rapides
LM Studio est la meilleure application LLM locale que j'ai utilisée (jusqu'à présent).
Ollama est bon, mais je préfère celui-ci.
J'ai commencé à expérimenter avec les modèles de langage locaux de grande taille (LLM) l'année dernière en utilisant Ollama.Ça fonctionnait plutôt bien, mais mon pauvre MacBook Air avec seulement 8 Go de RAM n'était clairement pas conçu pour supporter une telle charge de travail. Je voulais tout de même tenter une autre approche, en partie par curiosité et en partie pour voir si je pouvais obtenir des performances encore meilleures.
C'est pourquoi j'ai décidé d'essayer LM Studio. Cette application permet de télécharger et d'exécuter localement des modèles de langage complexes (LLM) sur son ordinateur, et son interface utilisateur est très claire. Utilisant un Mac, la compatibilité avec MLX était essentielle pour moi. Pour rappel, MLX est le framework d'apprentissage automatique d'Apple, conçu spécifiquement pour les processeurs Apple Silicon.
Concrètement, cela permet aux modèles de s'exécuter plus efficacement grâce au processeur graphique (GPU). Cependant, je souhaitais traduire ces propos en chiffres ; j'ai donc comparé directement Ollama et LMStudio, en utilisant le même modèle.
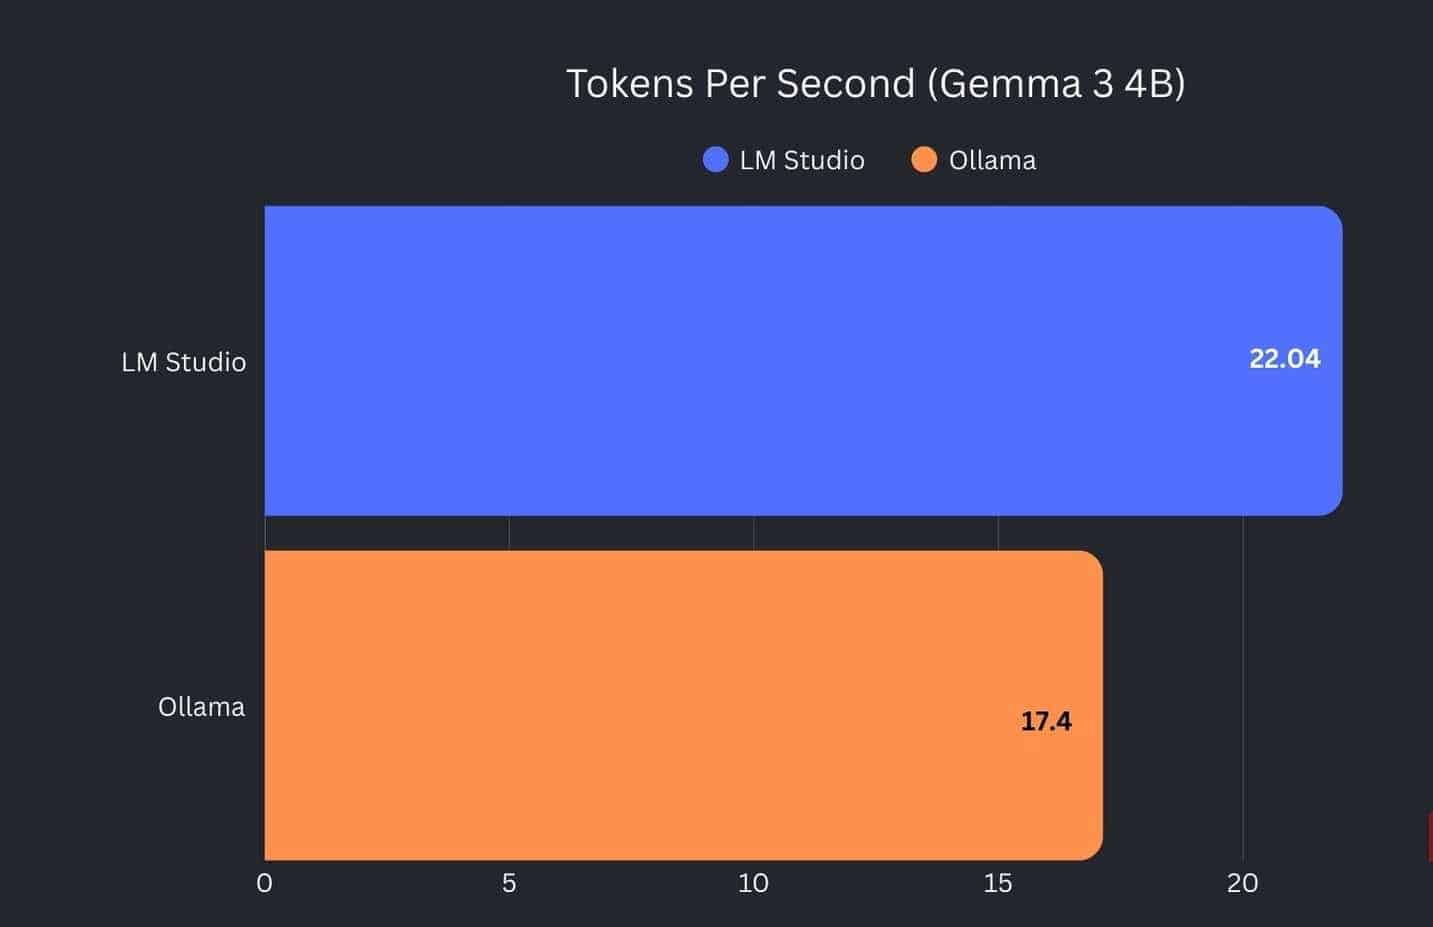
J'obtenais un nombre de symboles par seconde plus élevé avec LM Studio, mais la différence était si minime qu'elle n'a pas vraiment influencé l'expérience globale. Cependant, j'aurais apprécié tout gain de performance.
Cependant, je ne pense pas que cela fasse une grande différence entre Ollama et LM Studio, d'autant plus qu'ils reposent tous deux sur des frameworks de base similaires pour l'exécution locale des modèles.
Au début, mon principal reproche concernait le manque de prise en charge multimédia. Mais ce n'est plus un problème. Ollama et LM Studio prennent désormais en charge les modèles multimédias, et plusieurs options performantes permettent de gérer efficacement le texte et les images sur les appareils locaux.
Choisir le bon modèle peut s'avérer un peu difficile.
Cela peut être un passe-temps coûteux
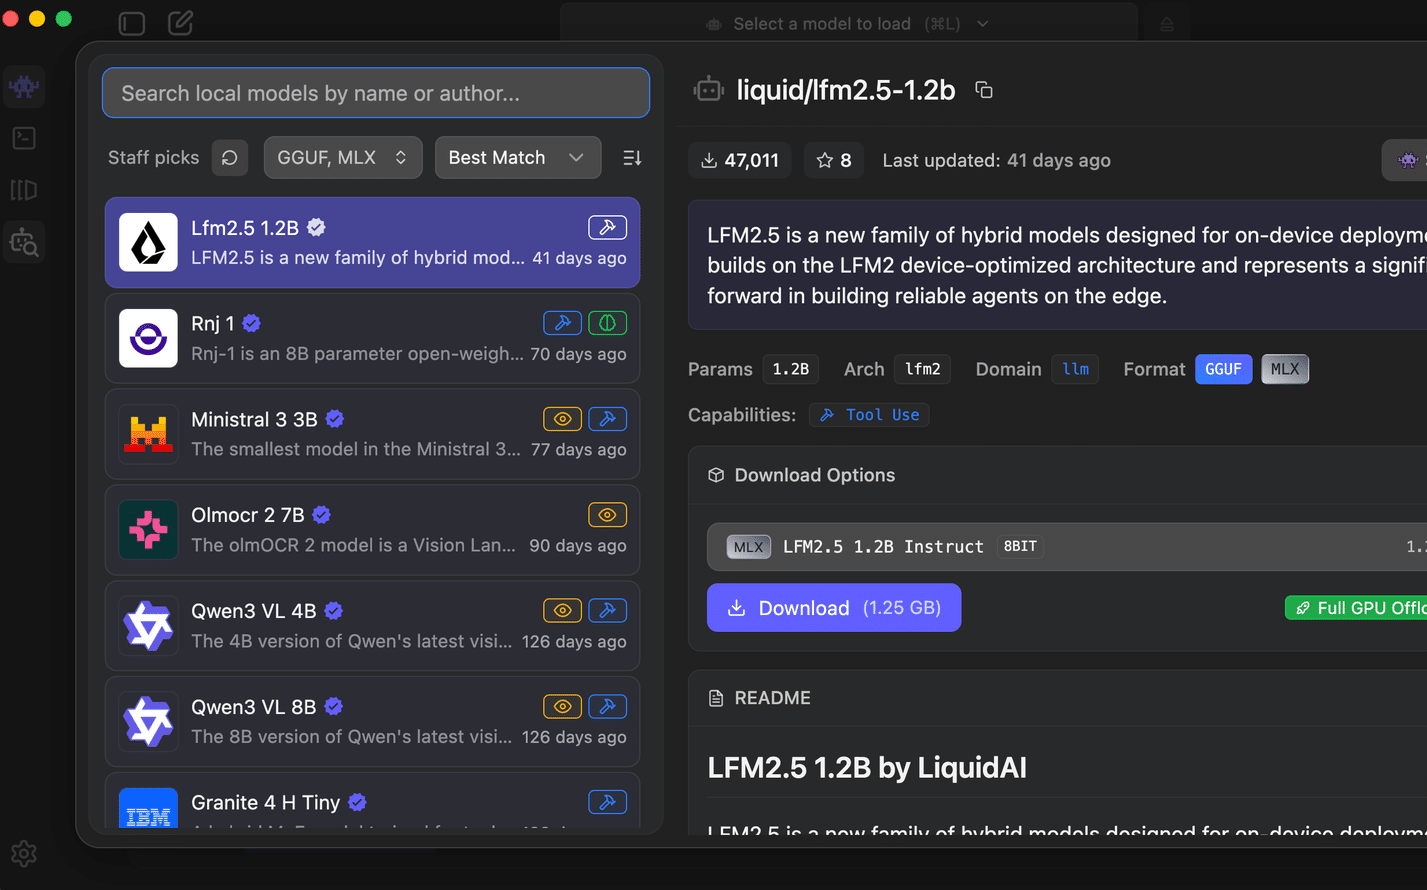
Lors de la première installation de LM Studio, vous devrez choisir un modèle. Si vous êtes novice, cela peut paraître déroutant, car il n'existe pas de solution unique et évidente : le modèle à utiliser dépend en réalité de votre matériel.
Si vous ouvrez le menu Recherche de modèles dans LM Studio, vous verrez une liste des modèles les plus populaires. Pour évaluer la popularité d'un modèle, il suffit de regarder le chiffre qui précède immédiatement la lettre « B » dans son nom.
Le « B » signifie milliards de paramètres. En général, plus ce nombre est élevé, plus le modèle est puissant. Cela signifie également qu'il nécessitera davantage de ressources. Sur un Mac équipé de 8 Go de VRAM, une fourchette de 3 à 4 milliards de paramètres me semble appropriée. La situation est un peu plus complexe sur un PC. Dans ce cas, c'est la quantité de VRAM disponible, et non la RAM classique, qui importe le plus.
Avec 8 Go de VRAM, vous pouvez expérimenter sans problème avec 7 milliards de paramètres, notamment dans des configurations quantiques plus légères. D'après mon expérience, la meilleure approche consiste à commencer par un modèle plus petit et à l'augmenter progressivement jusqu'à trouver la configuration optimale.
Personnellement, j'étais davantage attiré par le modèle Gemma 3 4B, qui repose sur la même architecture que les modèles Gemini de Google. Cependant, je vous recommande également d'essayer les modèles Qwen. Selon vos besoins, ils pourraient être bien plus adaptés.
Vous pouvez même ajouter la recherche Web à votre LLM local
DuckDuckGo vient à la rescousse
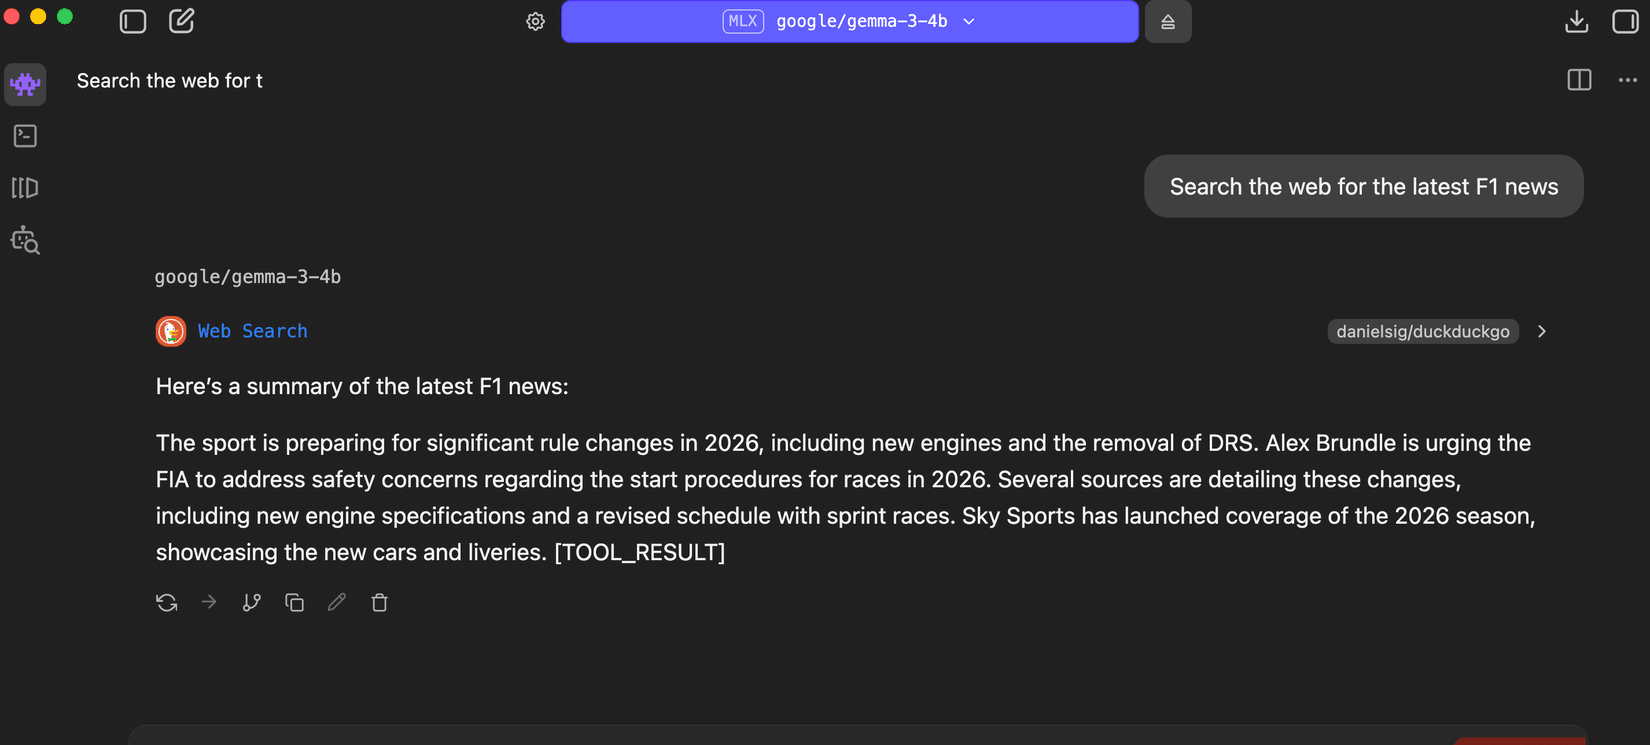
L'un des principaux reproches que j'ai constatés à l'égard des modèles de langage natifs (LLM) concerne leurs limitations en matière de recherche web, comparés aux modèles basés sur le cloud comme ChatGPT. Il est peu pertinent de demander des informations sur le dernier iPhone et de s'attendre à ce que le LLM réponde par l'iPhone 14. C'est un domaine où les modèles basés sur le cloud se sont révélés supérieurs.
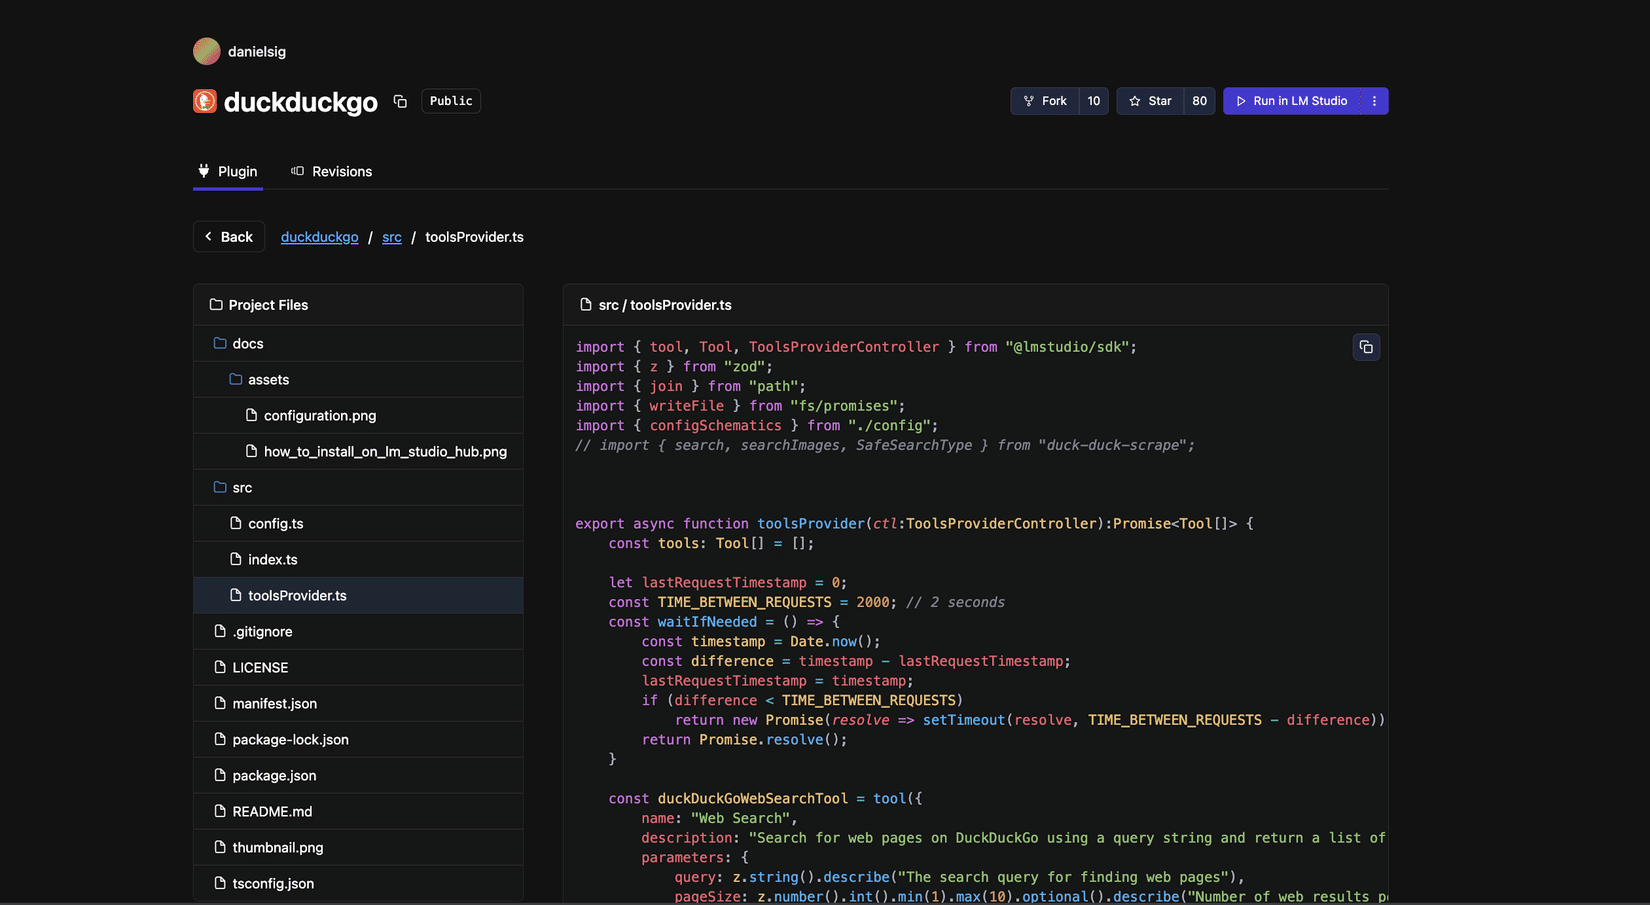
LM Studio possède un système de plugins intégré, et l'ajout d'une fonction de recherche Web est incroyablement simple. Il suffit d'aller sur Page d'extension DuckDuckGoEt spécifiez « Exécuter dans LM Studio ».
Une fois activée, cette option apparaîtra sous la zone de chat lorsque vous remplirez un formulaire. Elle vous proposera d'utiliser DuckDuckGo pour votre requête. Si vous l'activez, LM Studio récupérera les résultats de recherche en direct et les intégrera au formulaire avant de générer une réponse.
Ce n'est pas tout ce que vous pouvez faire avec les plugins. L'équipe de LM Studio en a également développé quelques-uns très utiles. Par exemple, ils proposent un plugin Wikipédia qui permet à votre modèle de langage de grande taille de lire et de rechercher des articles sur Wikipédia (évidemment).
Il y a aussi le plugin JavaScript Sandbox, qui peut s'avérer très utile si vous vous intéressez au codage expérimental et souhaitez avoir rapidement une idée générale de ce qu'il faut construire. Mais je ne dirais pas que cela vaut la peine de déployer autant d'efforts pour créer quelque chose de prêt pour la production.
Débarrassez-vous des grandes entreprises
Vous pouvez configurer LM Studio pour accéder à votre modèle de langage volumineux depuis votre téléphone, mais si vous souhaitez transférer toutes les inférences directement sur votre téléphone, c'est également possible. Exécuter des modèles de langage plus petits et plus grands sur un téléphone AndroidBien que ses performances ne soient pas aussi élevées que celles d'un Mac.
L'amélioration de ces modèles légers se poursuit à un rythme rapide et impressionnant. Compte tenu de la hausse attendue du coût du matériel, je ne serais pas surpris que des entreprises comme OpenAI ou Google augmentent leurs tarifs d'abonnement. Il est rassurant de disposer d'une configuration qui reste à l'abri de ces fluctuations.