L’exécution de modèles d’IA hors ligne serait idéale, mais cela nécessite généralement du matériel puissant et coûteux. Cependant, ce n’est pas toujours le cas : le modèle DeepSeek R1 offre une option pratique pour les appareils aux capacités limitées, et il est également incroyablement facile à installer.

Liens rapides
Que signifie exécuter un chatbot IA localement ?
Lorsque vous utilisez des chatbots IA en ligne comme ChatGPT, vos demandes sont traitées sur les serveurs d'OpenAI, ce qui signifie que votre appareil ne fait pas le gros du travail. Vous avez besoin d’une connexion Internet constante pour communiquer avec les chatbots IA, et vous n’aurez jamais le contrôle total de vos données. Les grands modèles de langage qui alimentent les chatbots IA, tels que ChatGPT, Gemini, Claude, etc., ont des exigences de fonctionnement très élevées en raison de leur dépendance aux GPU avec une grande capacité de mémoire vidéo (VRAM). Pour cette raison, la plupart des modèles d’IA sont basés sur le cloud.
Le chatbot IA local est installé directement sur votre appareil, comme tout autre logiciel. Cela signifie que vous n'avez pas besoin d'une connexion Internet constante pour utiliser le chatbot AI et que vous pouvez envoyer une demande à tout moment. DeepSeek-R1 est un grand modèle de langage natif qui peut être installé sur de nombreux appareils. Son modèle distillé 7B (sept milliards de paramètres) est une version plus petite et optimisée qui fonctionne bien sur les appareils de milieu de gamme, me permettant de générer des réponses d'IA sans traitement cloud. En termes simples, cela signifie des réponses plus rapides, une meilleure confidentialité et un contrôle total sur mes données.
Comment installer DeepSeek-R1 sur un ordinateur portable
L'exécution de DeepSeek-R1 sur votre appareil est relativement simple, mais gardez à l'esprit que vous utilisez une version moins puissante du chatbot IA basé sur le Web de Recherche profonde. Le chatbot IA de DeepSeek utilise environ 671 milliards de paramètres, alors qu'il contient DeepSeek-R1 Sur environ 7 milliards de paramètres.
Vous pouvez télécharger et utiliser DeepSeek-R1 sur votre ordinateur en suivant ces étapes :
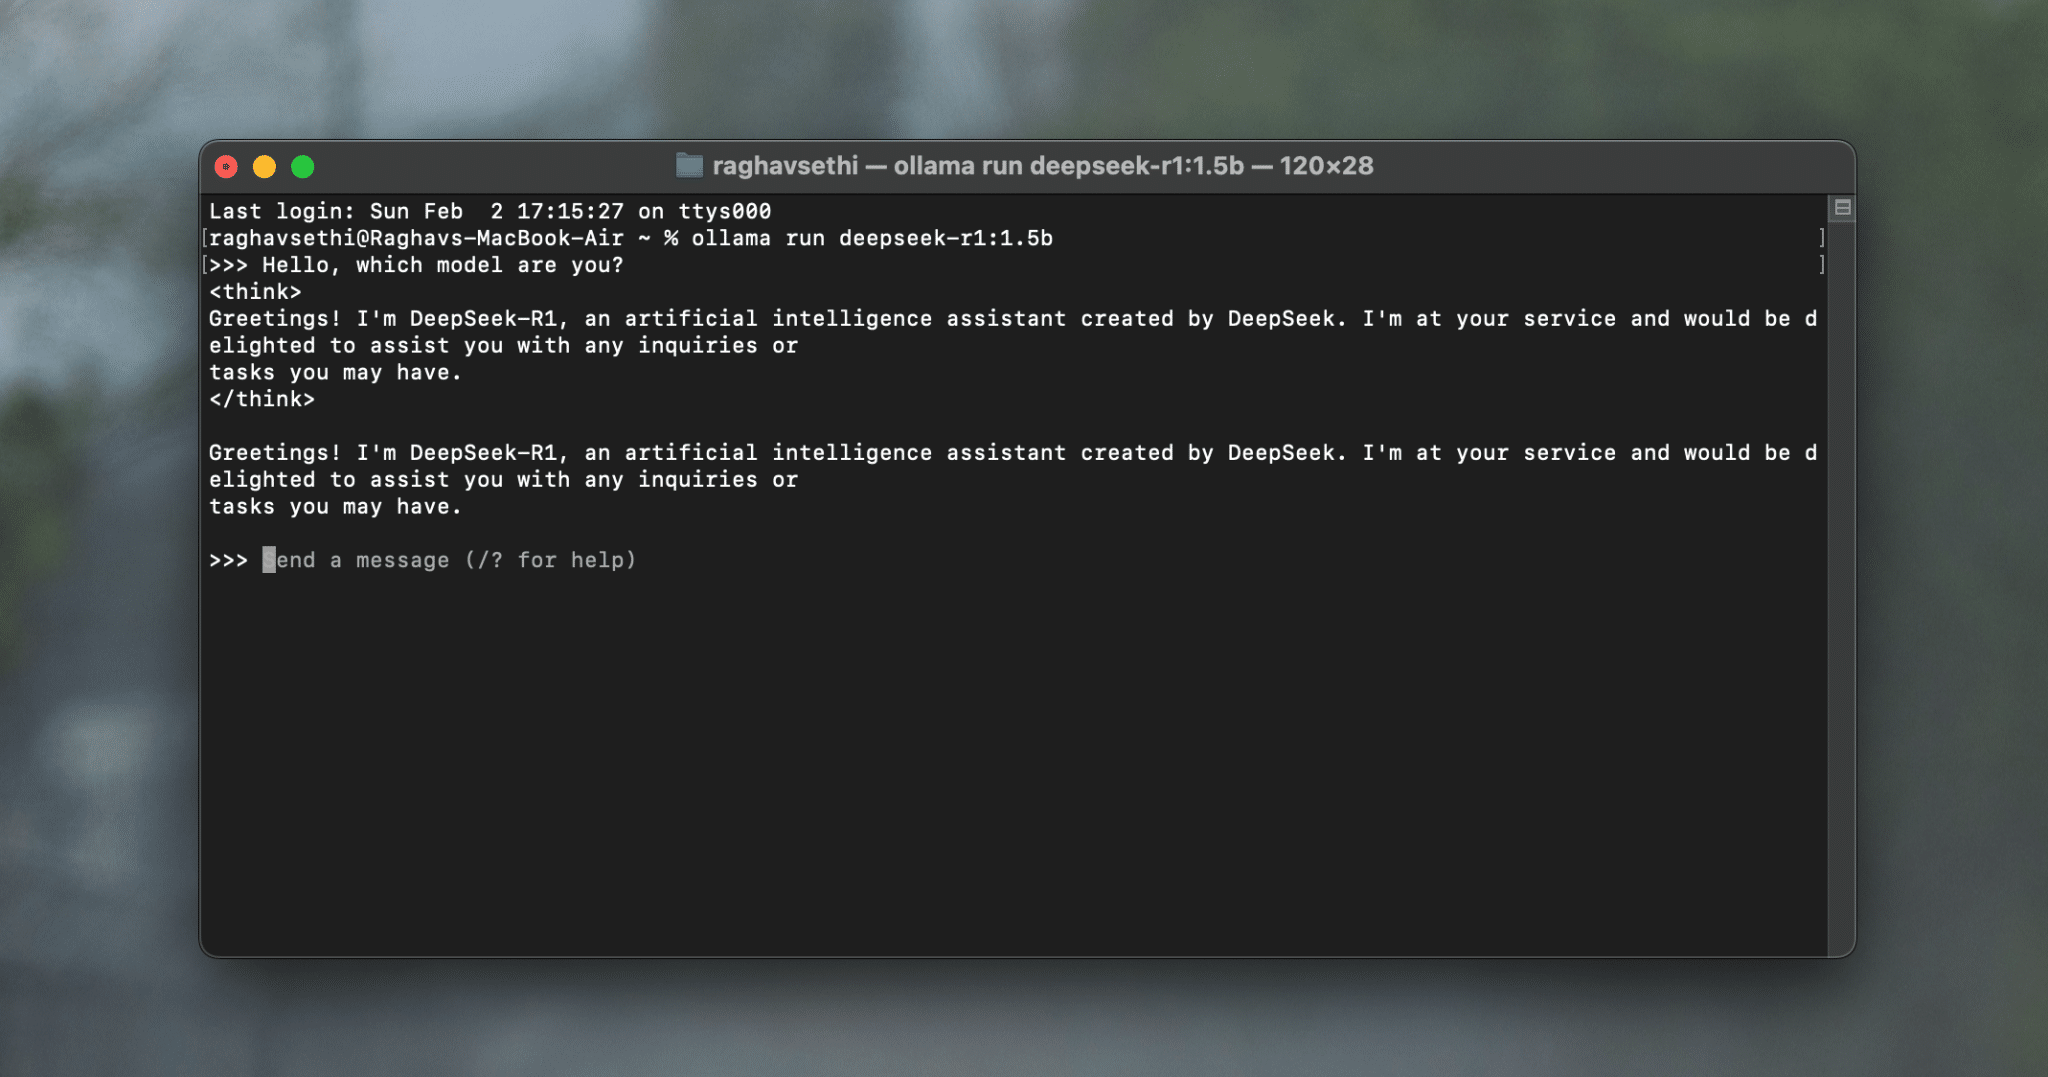
- Aller à Site Web d'Ollama Et téléchargez la dernière version. Ensuite, installez-le sur votre appareil comme n’importe quelle autre application.
- Ouvrez le Terminal et tapez la commande suivante :
ollama run deepseek-r1:7b
Cela téléchargera le modèle DeepSeek-R1 7B sur votre ordinateur, vous permettant de saisir des requêtes dans le terminal et de recevoir des réponses. Si vous rencontrez des problèmes de performances ou des plantages, essayez d'utiliser un modèle moins exigeant en remplaçant 7b B 1.5b Dans l'ordre ci-dessus.
Bien que le modèle fonctionne bien dans Terminal, si vous souhaitez une interface utilisateur complète avec un formatage de texte approprié comme ChatGPT, vous pouvez également utiliser une application comme Boîte de discussion.
L'exécution locale de DeepSeek n'est pas parfaite, mais cela fonctionne
Comme mentionné précédemment, les réponses ne seront pas aussi bonnes (ou rapides !) que celles du chatbot en ligne de DeepSeek, car il utilise un modèle plus puissant et traite tout dans le cloud. Mais voyons comment se comportent les modèles plus petits.
Résoudre des problèmes mathématiques
Pour tester les performances du modèle à 7 milliards de facteurs, je lui ai donné une équation et lui ai demandé de résoudre son intégrale. J'ai été très satisfait de ses performances, d'autant plus que les modèles de base ont souvent du mal avec les mathématiques. Cette expérience démontre la capacité des grands modèles de langage à gérer les problèmes de calcul, ce qui est très prometteur dans des domaines tels que la physique et l’ingénierie.
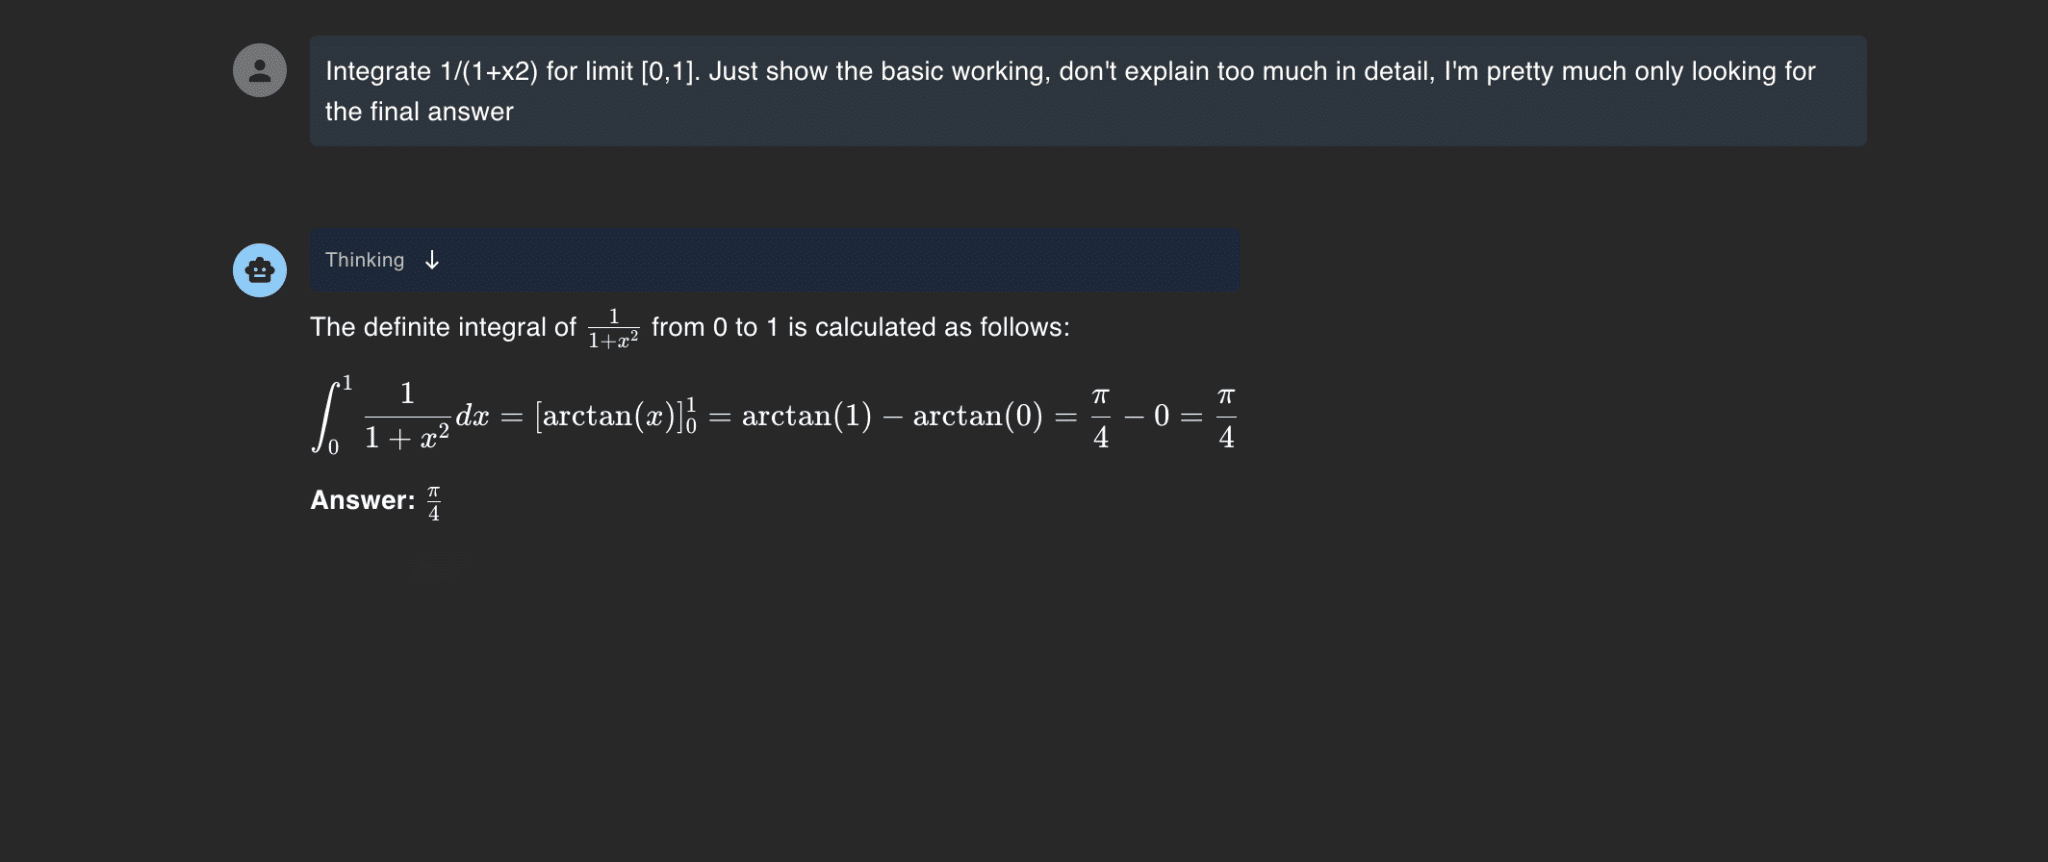
Ce n’est pas le problème le plus complexe, mais c’est exactement ce qui rend l’exécution d’un grand modèle de langage local si utile. Il s’agit de disposer d’un outil facilement disponible pour gérer instantanément des requêtes simples au lieu de s’appuyer sur le cloud pour tout. Cette approche améliore la vitesse de réponse et réduit la dépendance à la connectivité Internet, ce qui est essentiel dans les applications d’IA interactives.
Correction des erreurs dans le code
L’une des meilleures utilisations de l’exécution du modèle DeepSeek-R1 localement est d’aider aux projets d’IA. C'est très utile, surtout lorsque j'écris du code dans des avions où il n'y a pas d'accès Internet, et que je m'appuie fortement sur de grands modèles de langage pour le débogage. Pour tester son efficacité, je lui ai fourni ce code avec une erreur simple et intentionnelle ajoutée.
Il a géré le code facilement, mais il convient de noter que je l'exécutais sur un MacBook Air M1 avec seulement 8 Go de mémoire unifiée. (La mémoire unifiée est une mémoire partagée entre le CPU, le GPU et d'autres parties d'un système sur puce.)
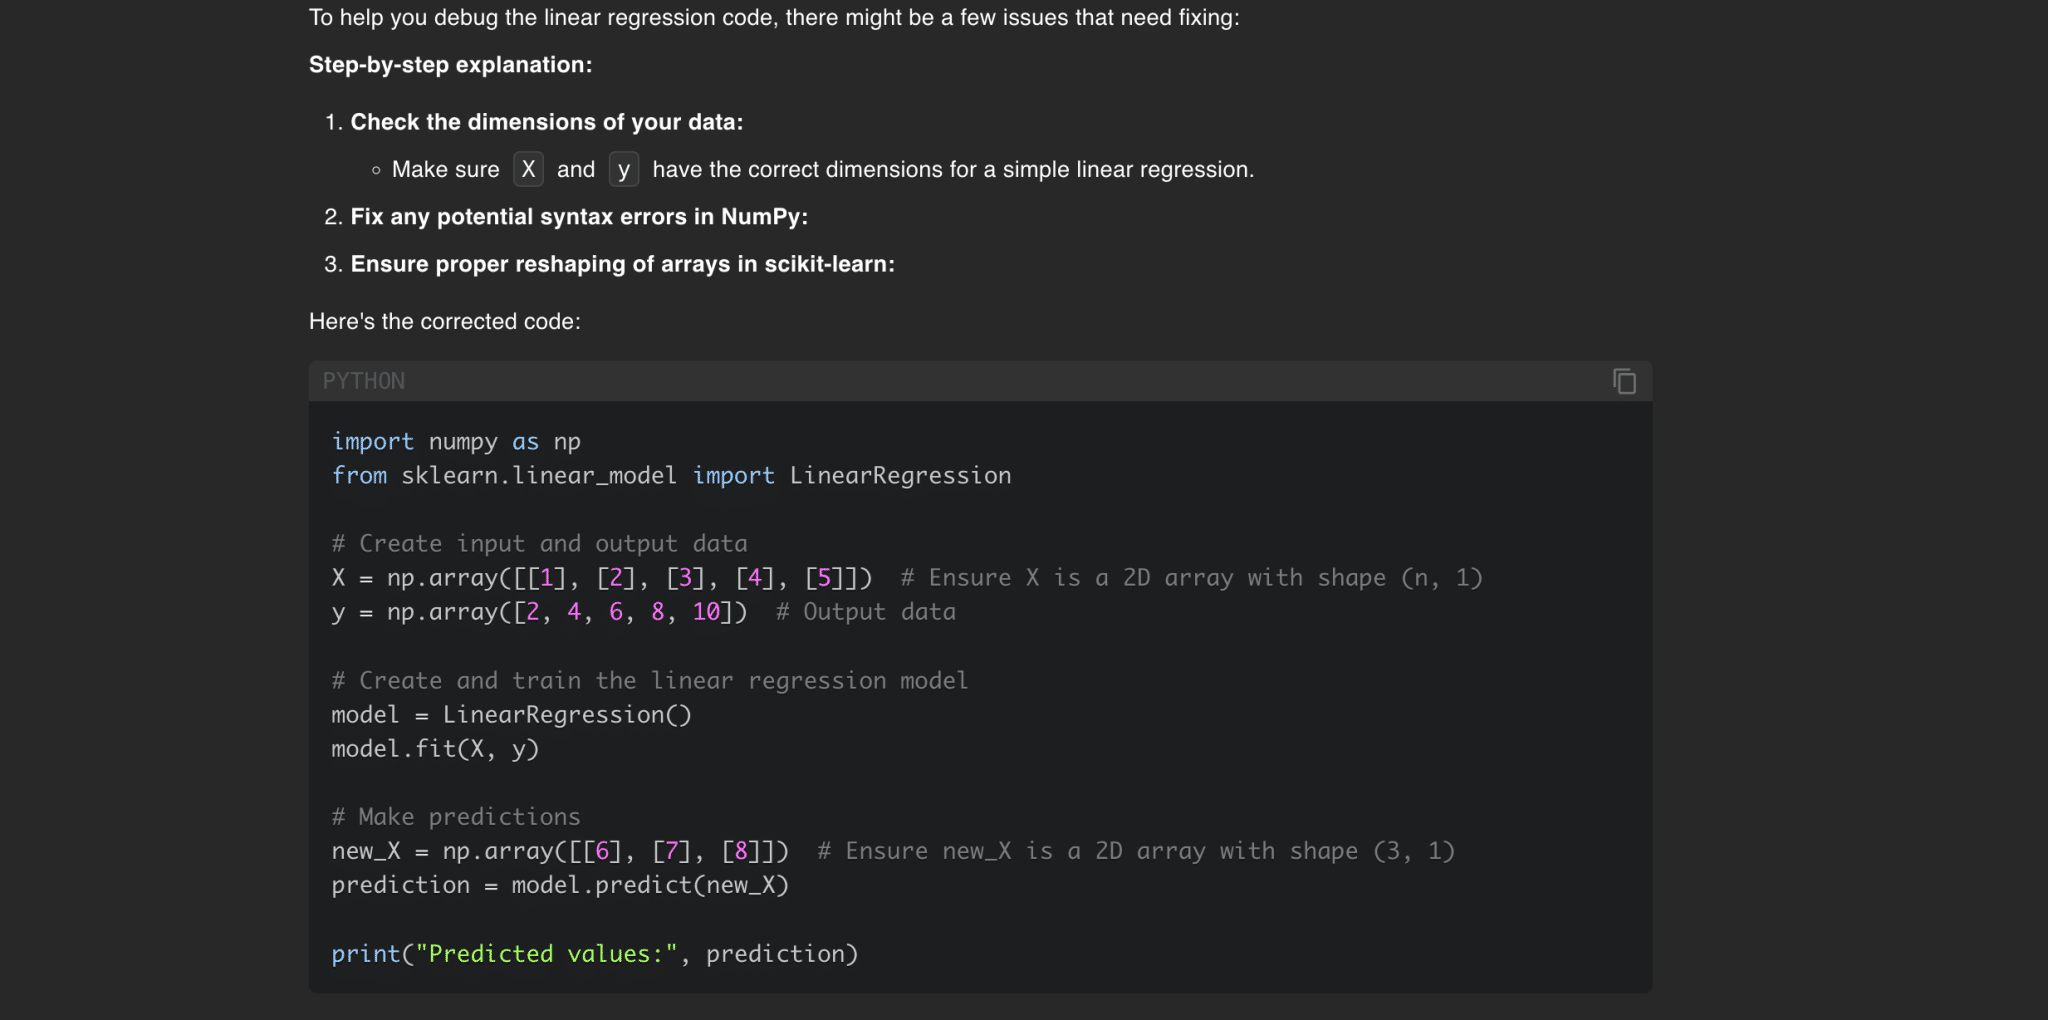
Avec l'IDE ouvert et plusieurs onglets de navigateur ouverts, les performances de mon MacBook ont pris un coup majeur : j'ai dû tout fermer de force pour qu'il redevienne réactif. Si vous disposez de 16 Go de RAM ou même d'un GPU de milieu de gamme, vous ne rencontrerez probablement pas ces problèmes.
Je l'ai également testé avec des bases de code plus grandes, mais il reste bloqué dans une boucle, je ne recommanderais donc pas de s'y fier comme un remplacement complet pour des modèles plus puissants. Cependant, il reste utile pour créer rapidement de petits extraits de code.
Résolvez des puzzles
J'étais également curieux de voir à quel point le modèle gérait les énigmes et le raisonnement logique, alors je l'ai testé avec un problème : Salle Monty, que j'ai résolu facilement, mais j'ai vraiment commencé à apprécier DeepSeek pour une autre raison.
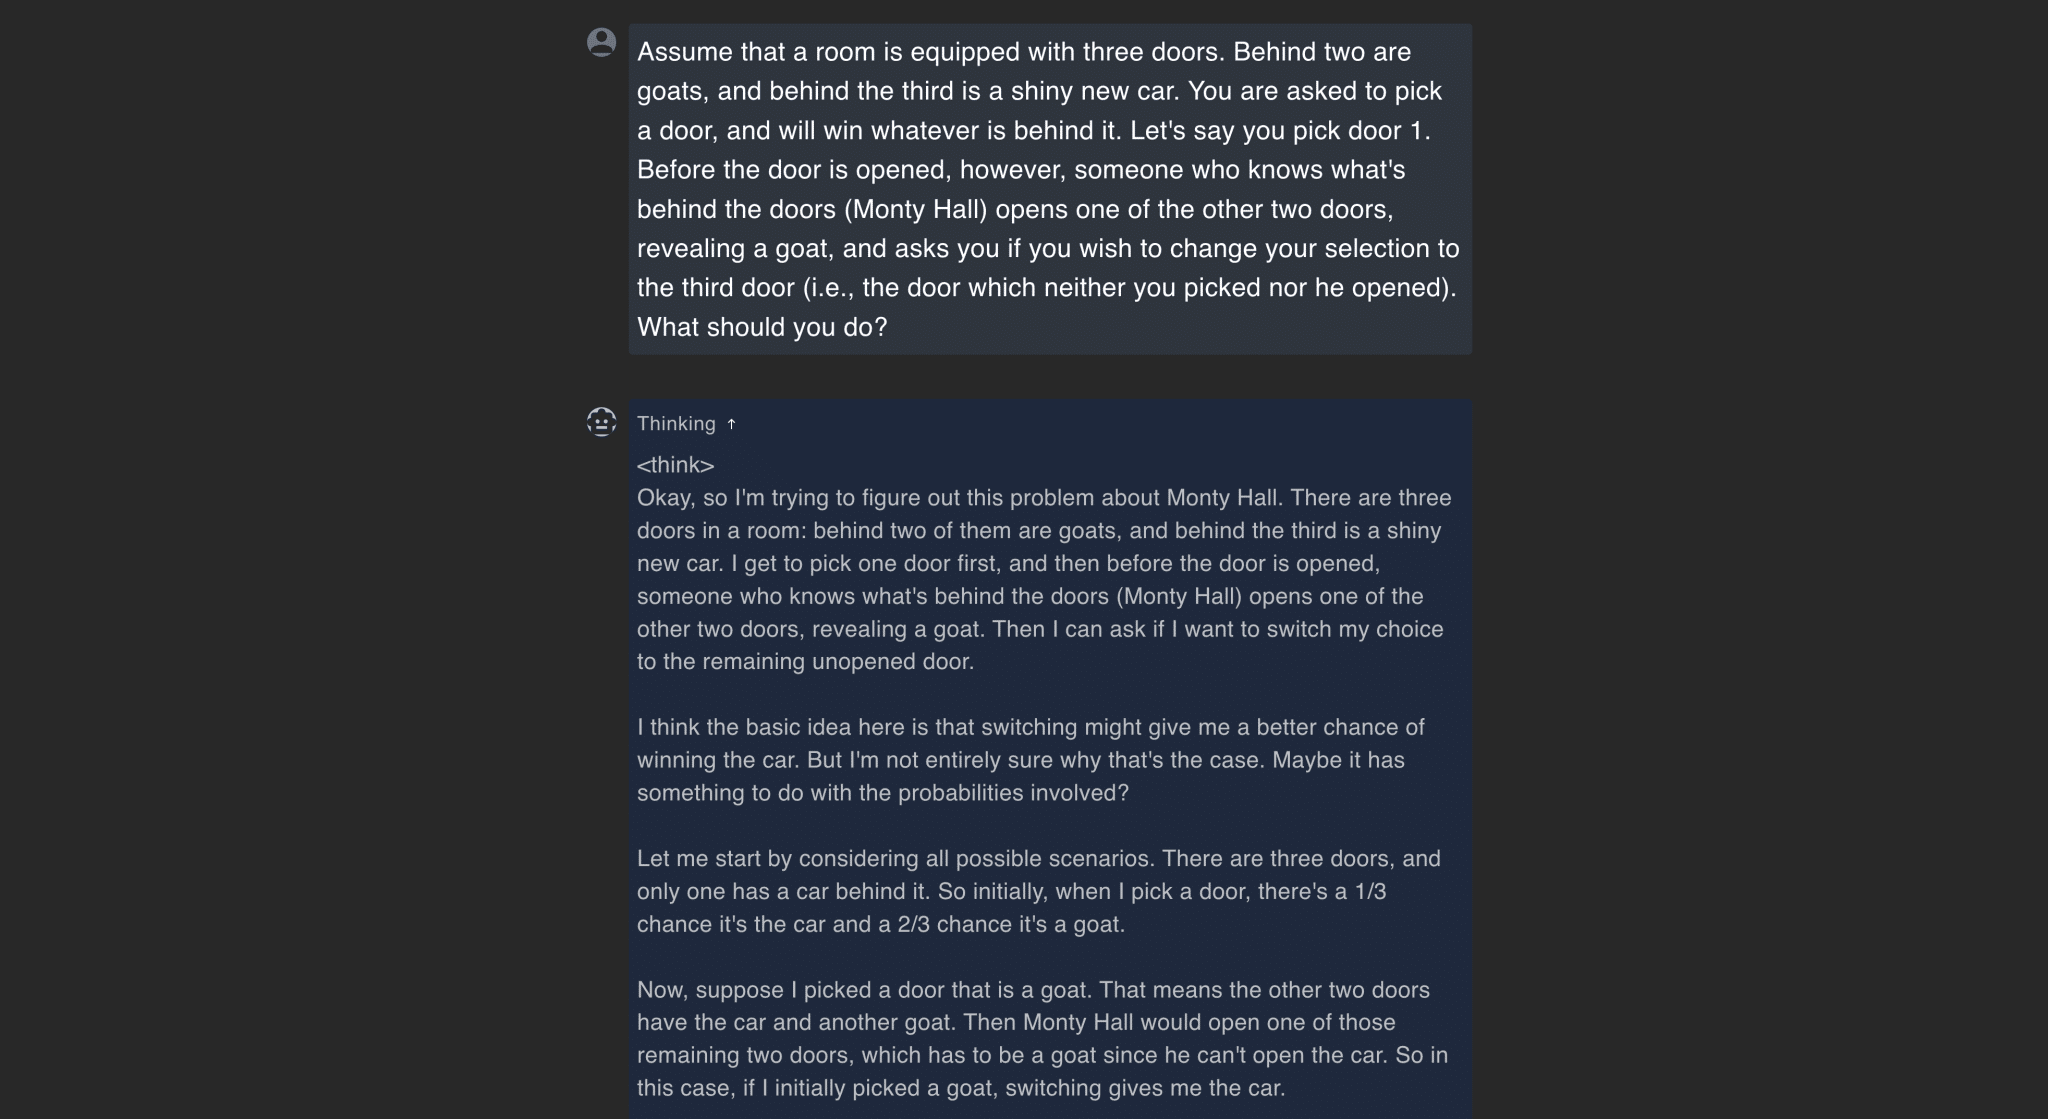
Comme le montre l'image, il ne vous donne pas seulement la réponse, il vous guide tout au long du processus de réflexion, en vous expliquant comment il est arrivé à la solution. Cela montre qu’il réfléchit au problème plutôt que de simplement rappeler une réponse mémorisée à partir de ses données de formation. Cela indique que DeepSeek est capable de traiter des informations et de déduire des solutions d’une manière qui imite la pensée humaine, ce qui constitue une étape importante dans le développement de modèles d’IA.
Recherches
L’un des plus gros inconvénients de l’exécution locale d’un grand modèle linguistique est la discontinuité des connaissances. Comme il ne peut pas accéder à Internet, il peut être difficile de trouver des informations fiables sur les événements récents. Cette limitation était évidente lors de mes tests, mais elle s’est aggravée lorsque j’ai demandé un bref aperçu de l’iPhone d’origine — cela a généré une réponse inexacte et involontairement drôle.
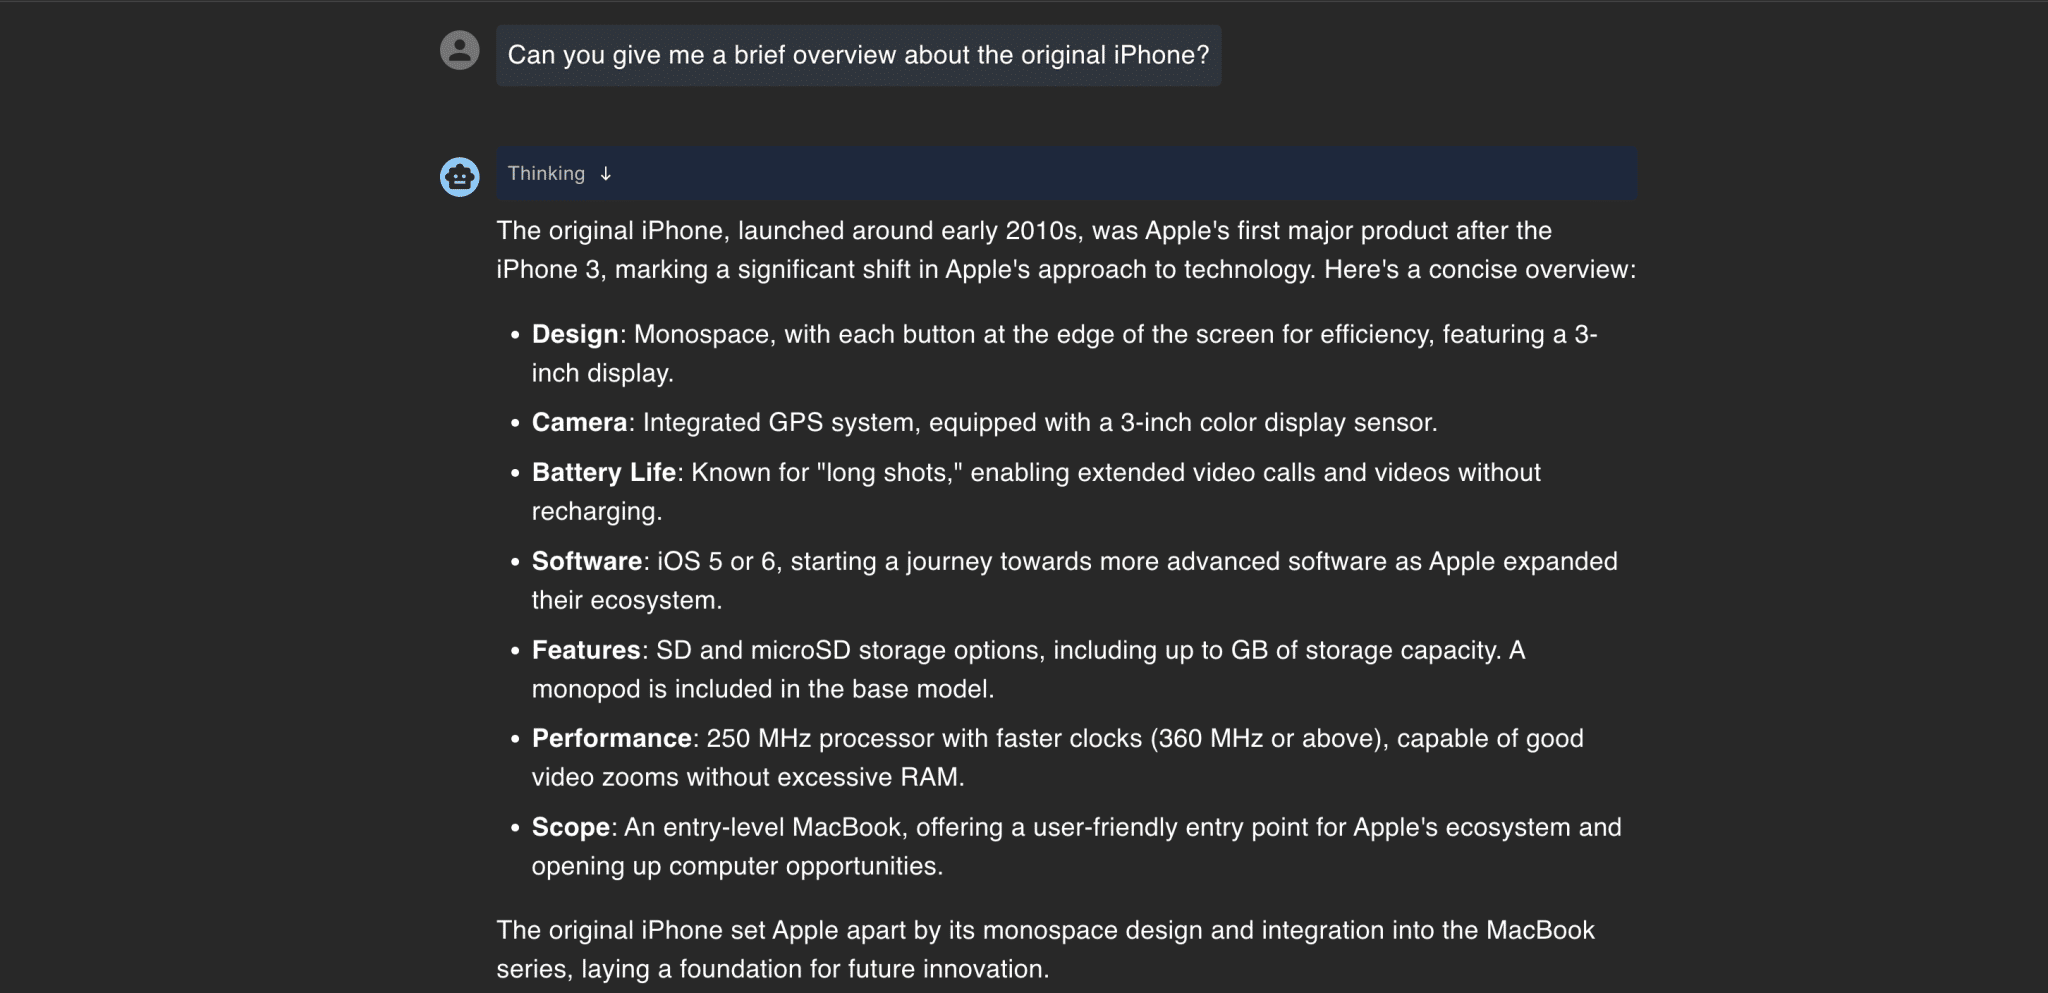
De toute évidence, le premier iPhone n'a pas été lancé avec iOS 5, et l'inexistant « iPhone 3 » n'est pas encore sorti. Il a presque tout faux. Je l'ai testé avec quelques autres questions de base, mais l'inexactitude a persisté.
بعد Violation de données DeepSeekJe me suis senti rassuré de savoir que je pouvais exécuter ce modèle localement sans craindre que mes données soient compromises. Même si ce n’est pas parfait, avoir un assistant IA hors ligne est un énorme avantage. J'aimerais voir plus de modèles comme celui-ci intégrés dans des appareils grand public comme les smartphones, surtout après Ma déception envers Apple Intelligence.