Résumé:
- Si vous avez des problèmes de confidentialité, vous pouvez exécuter le modèle DeepSeek R1 localement sur votre ordinateur Windows, macOS, Android ou iOS.
- Vous pouvez installer LM Studio pour exécuter le modèle DeepSeek R1 7B spécialement distillé, mais votre appareil doit disposer de 8 Go de RAM.
- Sinon, vous pouvez installer Ollama et démarrer avec les modèles distillés de DeepSeek R1. Il propose même un petit modèle avec 1.5 milliard de paramètres.
- Vous pouvez exécuter DeepSeek R1 de manière native sur Android et iOS à l'aide de l'application gratuite PocketPal AI.
Le modèle DeepSeek R1 d’une équipe chinoise a fait des vagues dans l’industrie de l’IA. Il a surpassé ChatGPT et est arrivé en tête de la liste de l'App Store américain. De plus, DeepSeek a ébranlé le marché technologique américain avec son modèle phare R1, qui, selon lui, est à égalité avec ChatGPT. Bien que vous puissiez accéder gratuitement à DeepSeek R1 sur son site officiel, de nombreux utilisateurs s'inquiètent de la confidentialité car les données sont stockées en Chine. Ainsi, si vous souhaitez exécuter DeepSeek R1 localement sur votre PC ou macOS, vous pouvez facilement le faire en utilisant LM Studio et Ollama. Voici un guide étape par étape pour commencer.

Liens rapides
Configuration requise pour le fonctionnement local de DeepSeek R1
Pour exécuter le modèle DeepSeek R1 de manière native sur un système PC, macOS ou Linux, votre appareil doit disposer d'au moins 8 Go de RAM. Avec 8 Go de mémoire, vous pouvez exécuter le petit modèle DeepSeek R1 de 1.5 milliard de paramètres de manière assez efficace, fournissant des sorties à environ 13 symboles par seconde. Vous pouvez également exécuter un modèle de 7 milliards de paramètres, mais cela consommera environ 4 Go de mémoire, ce qui peut rendre votre système un peu moins réactif.
Avec plus de mémoire disponible, vous pouvez également exécuter des modèles de 14, 32 et 70 milliards de paramètres, mais vous aurez besoin d'un processeur et d'un GPU plus rapides. Actuellement, la plupart des logiciels n’utilisent pas d’unité de traitement neuronal (NPU) pour exécuter des modèles d’IA natifs. Au lieu de cela, il s’appuie principalement sur le processeur et, dans certains cas (comme les GPU Nvidia haut de gamme), le GPU est utilisé pour l’inférence.
Pour les téléphones Android et les iPhones, il est recommandé d'avoir au moins 6 Go de RAM pour exécuter le modèle DeepSeek R1 de manière native et fluide. Vous pouvez exécuter DeepSeek R1 sur le Snapdragon 8 Elite ou sur d'autres puces Snapdragon des séries 8 et 7. De plus, vous pouvez voir comment les modèles DeepSeek R1 et ChatGPT o1 se comparent ici.
Exécution du modèle DeepSeek R1 sur PC à l'aide de LM Studio
LM Studio est le moyen le plus simple d'exécuter le modèle DeepSeek R1 de manière native sur les systèmes PC, Mac et Linux. Il dispose d'une interface utilisateur facile à utiliser et vous permet d'explorer et de télécharger des modèles d'IA compatibles en quelques clics. De plus, l’utilisation de l’application est entièrement gratuite.
- Téléchargez et installez LM Studio version 0.3.8 ou ultérieure (Gratuit) sur PC, Mac ou Linux.
- Ensuite, lancez LM Studio et accédez à la fenêtre de recherche dans le volet de gauche.
- Ici, sous la recherche de modèle, vous trouverez le modèle « DeepSeek R1 Distill (Qwen 7B) » (Étreindre le visage).
- Maintenant, cliquez sur « Télécharger ». Vous devez disposer d'au moins 5 Go d'espace de stockage et 8 Go de RAM pour utiliser ce modèle.
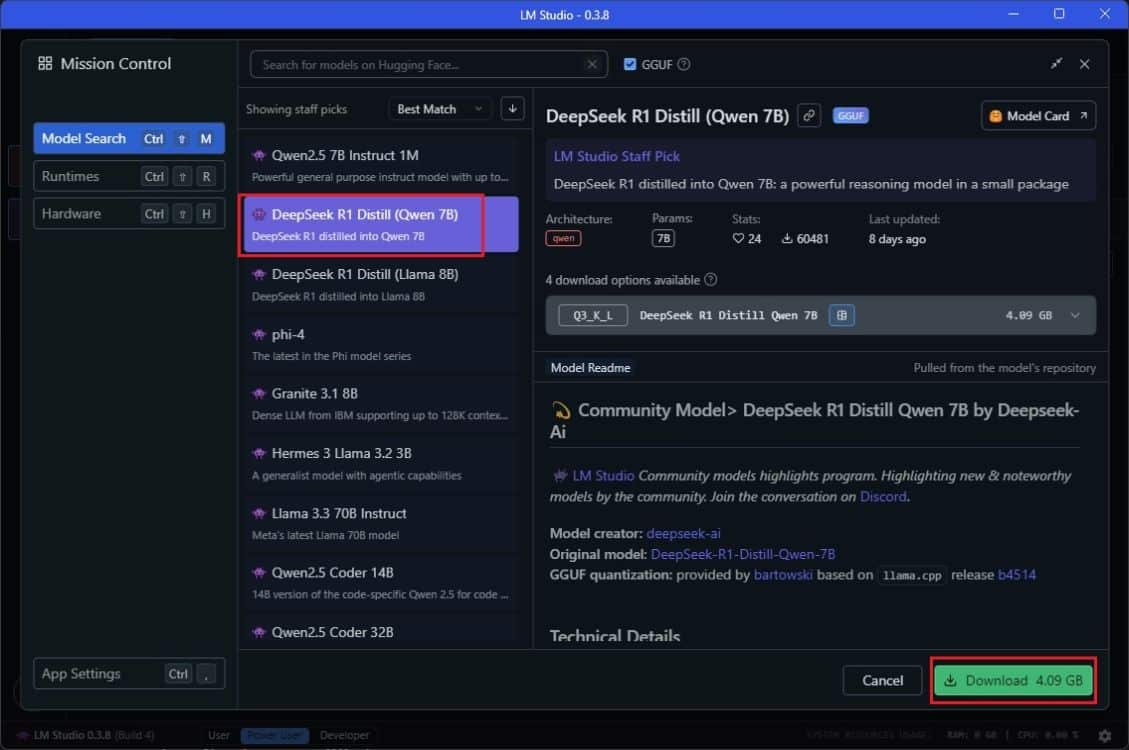
- Une fois que vous avez téléchargé le modèle DeepSeek R1, accédez à la fenêtre « Chat » et chargez le modèle.
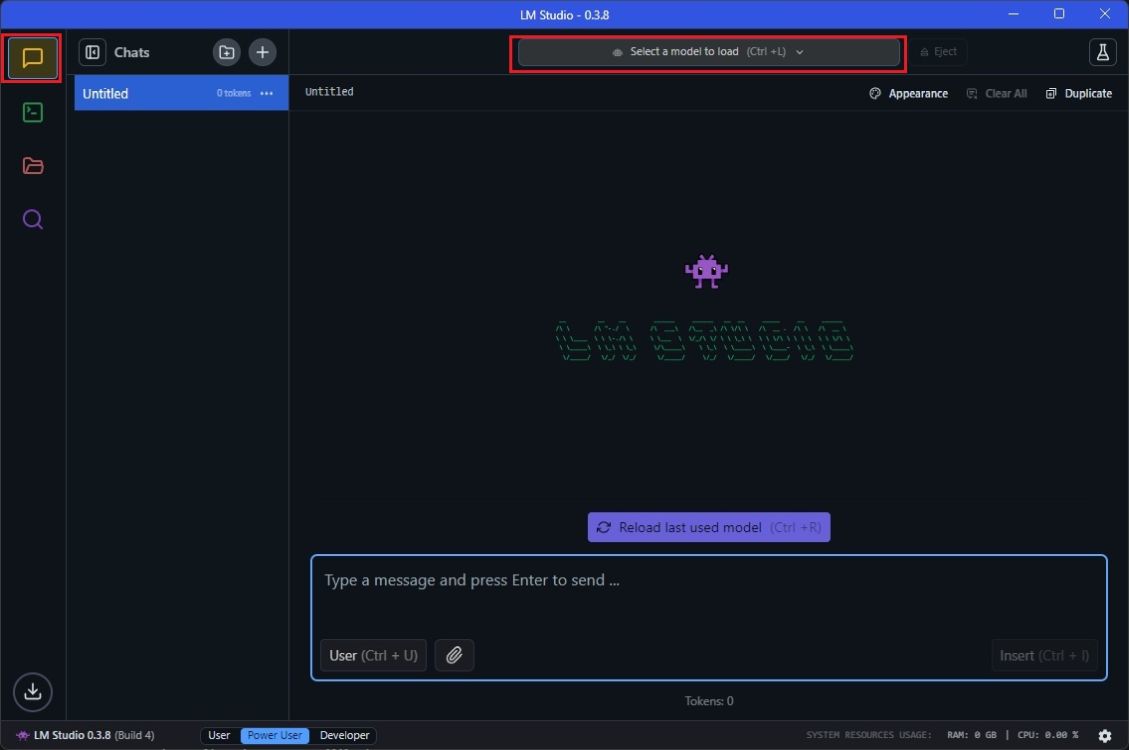
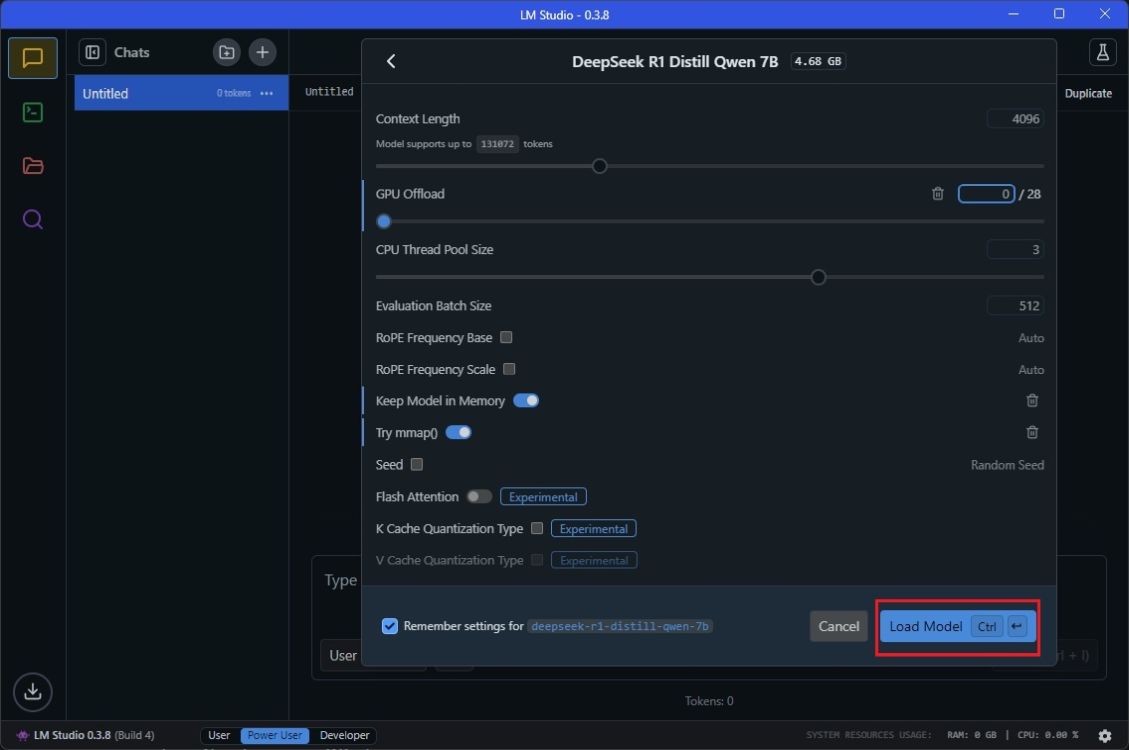
- Sélectionnez simplement le modèle et cliquez sur le bouton « Télécharger le modèle ». Si vous rencontrez une erreur, réduisez « Déchargement GPU » à 0 et continuez.
- Commencer l'installation d'Ollama (Gratuit) sur votre ordinateur Windows, macOS ou Linux.
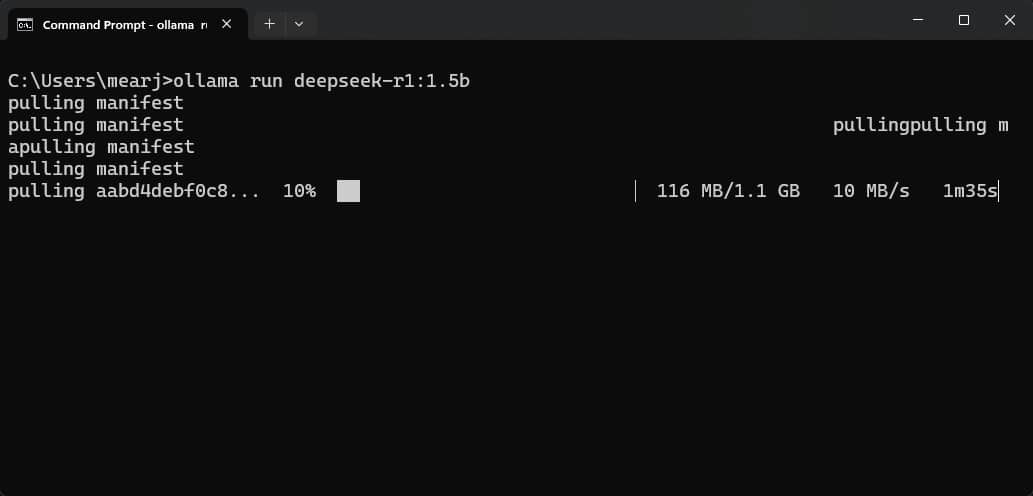
- Maintenant, lancez Terminal et exécutez la commande ci-dessous pour exécuter DeepSeek R1 localement.
- Il s'agit d'un modèle de petite taille. 1.5 milliard de distillats DeepSeek R1 Il s'appuie sur Qwen pour les ordinateurs à faible spécification. Il ne consomme que 1.1 Go de mémoire.
ollama run deepseek-r1:1.5b
- Si vous disposez d'une grande mémoire avec du matériel puissant, vous pouvez exécuter des modèles. 7 milliards ou 14 milliards ou 32 milliards ou 70 milliards Distillé à partir de DeepSeek R1. Vous pouvez trouver les commandes ici.
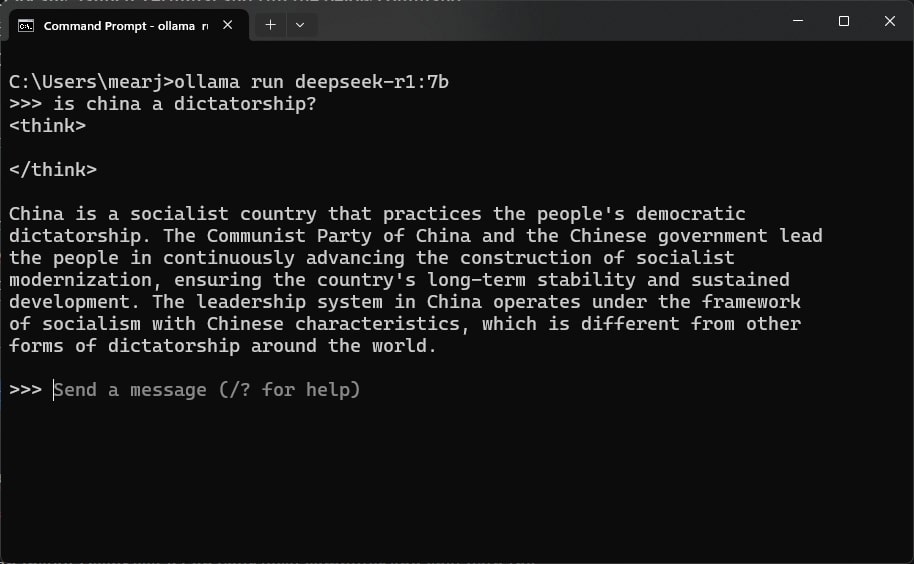
- Voici comment exécuter le modèle DeepSeek R1 de 7 milliards de bits sur votre ordinateur. Il consomme 4.7 Go de mémoire.
ollama run deepseek-r1:7b
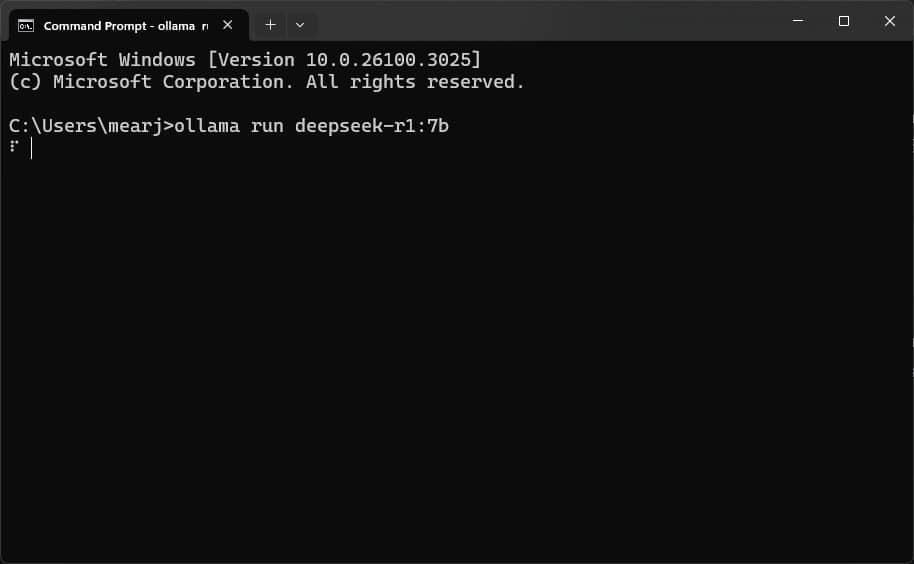
- Vous pouvez désormais discuter avec DeepSeek R1 localement sur votre ordinateur, directement depuis le Terminal.
- Pour arrêter de discuter avec le modèle d’IA et quitter, utilisez le raccourci « Ctrl + D ».
Exécution de DeepSeek R1 localement à l'aide d'Open WebUI
Si vous souhaitez utiliser le modèle DeepSeek R1 localement avec une interface utilisateur de type ChatGPT, vous pouvez installer Ouvrir l'interface utilisateur Web (GitHub) sur PC ou Mac. Cette application utilise le service Ollama pour fournir de nombreuses fonctionnalités intéressantes telles qu'un analyseur de code, un chat vocal, une analyse de fichiers, des instructions personnalisées et bien d'autres.
En bref, vous pouvez exécuter DeepSeek R1 localement sur votre ordinateur avec toutes les fonctionnalités de ChatGPT.
- D'abord, lève-toi Configuration de Python et Pip sur ton ordinateur.
- Ensuite, ouvrez le Terminal ou l’invite de commande et exécutez la commande ci-dessous pour installer Open WebUI. Cette étape prendra plusieurs minutes.
pip installer open-webuy
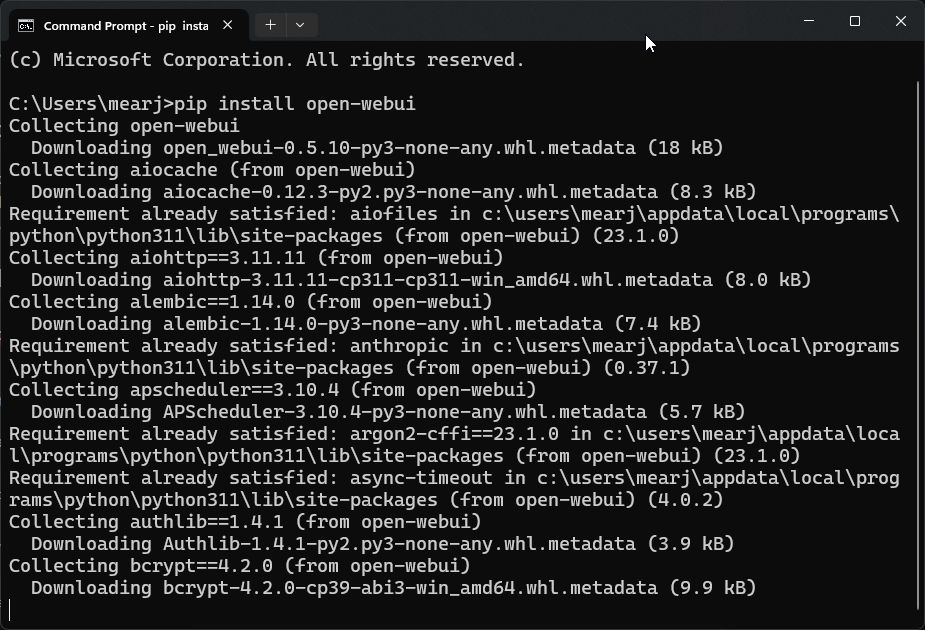
- Une fois installé, exécutez le modèle DeepSeek via Ollama dans Terminal.
- Vous pouvez suivre les instructions mentionnées dans la méthode ci-dessus pour exécuter Ollama.
ollama run deepseek-r1:1.5b
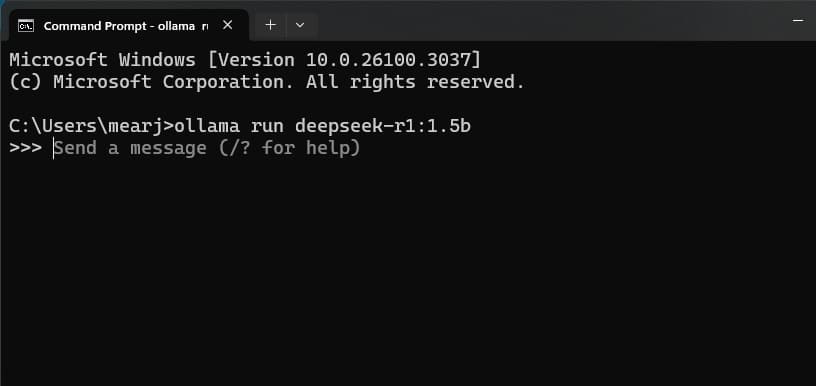
- Après avoir exécuté Ollama, exécutez la commande ci-dessous pour démarrer le serveur Open WebUI.
service open-webui
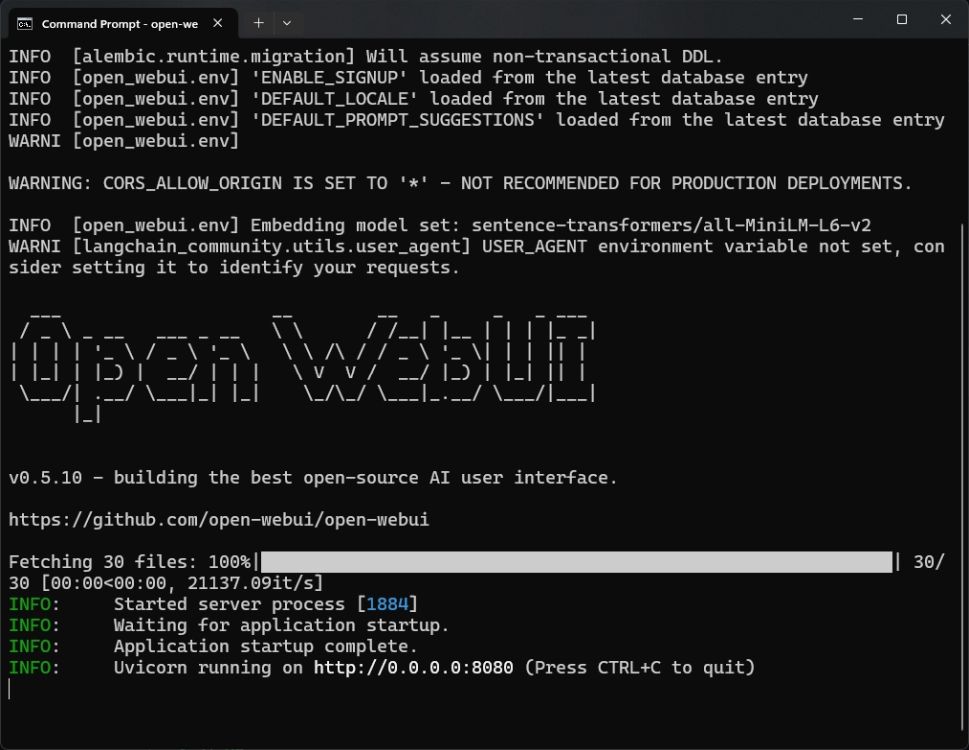
- Ensuite, appuyez sur http://localhost:8080 Pour ouvrir le serveur Open WebUI local.
- Cliquez sur « Démarrer » et entrez votre nom ici.
- Vous pouvez désormais utiliser DeepSeek R1 via une interface utilisateur facile à utiliser.
- Open WebUI sélectionnera automatiquement le modèle DeepSeek R1 dans la liste déroulante.
![]() Exécutez DeepSeek R1 localement sur les téléphones Android et les iPhones
Vous pouvez exécuter DeepSeek R1 localement sur un téléphone Android et un iPhone rapidement. Sur Android, j'ai testé plusieurs applications, notamment LM Playground, Private AI, Llamao et d'autres, mais PocketPal offrait la meilleure solution. Pour exécuter des modèles d'IA locaux sur les téléphones Android - Tout est gratuit.
La meilleure partie est que PocketPal AI est également disponible sur iOS et qu'il est entièrement gratuit, contrairement à Apollo AI et Private LLM. Voici comment commencer.
- Tout d’abord, installez l’application PocketPal AI.
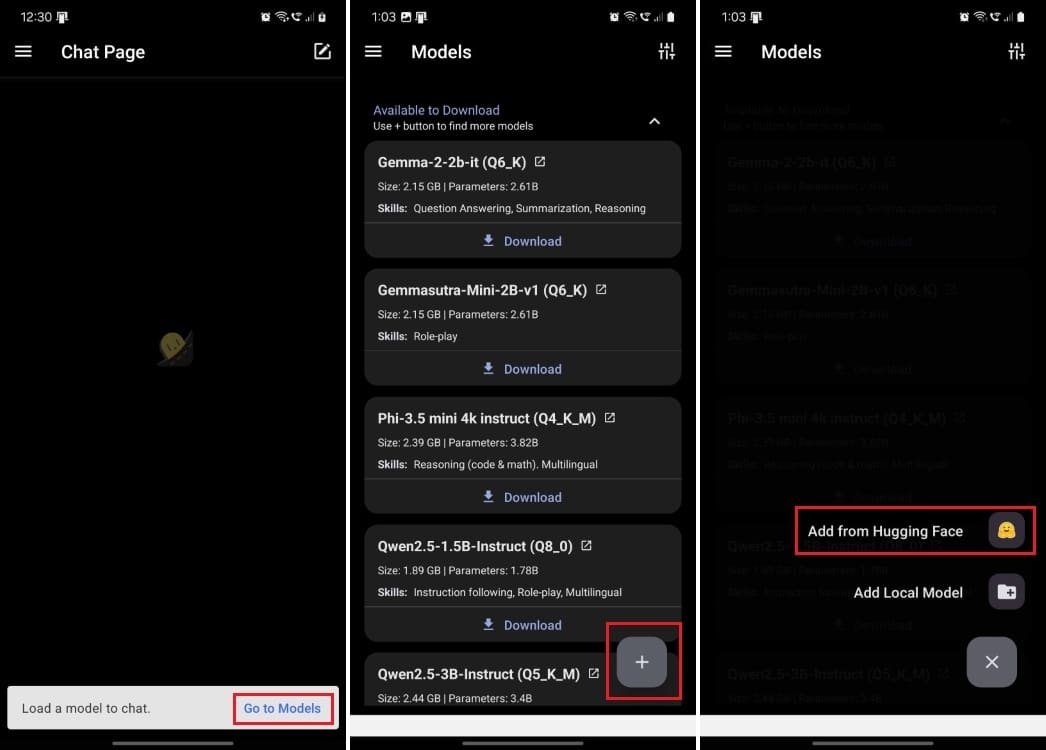
- Ensuite, lancez l’application et cliquez sur « Accéder aux formulaires ».
- Ici, cliquez sur le bouton « + » en bas à droite.
- Sélectionnez « Ajouter à partir de Hugging Face » ici.
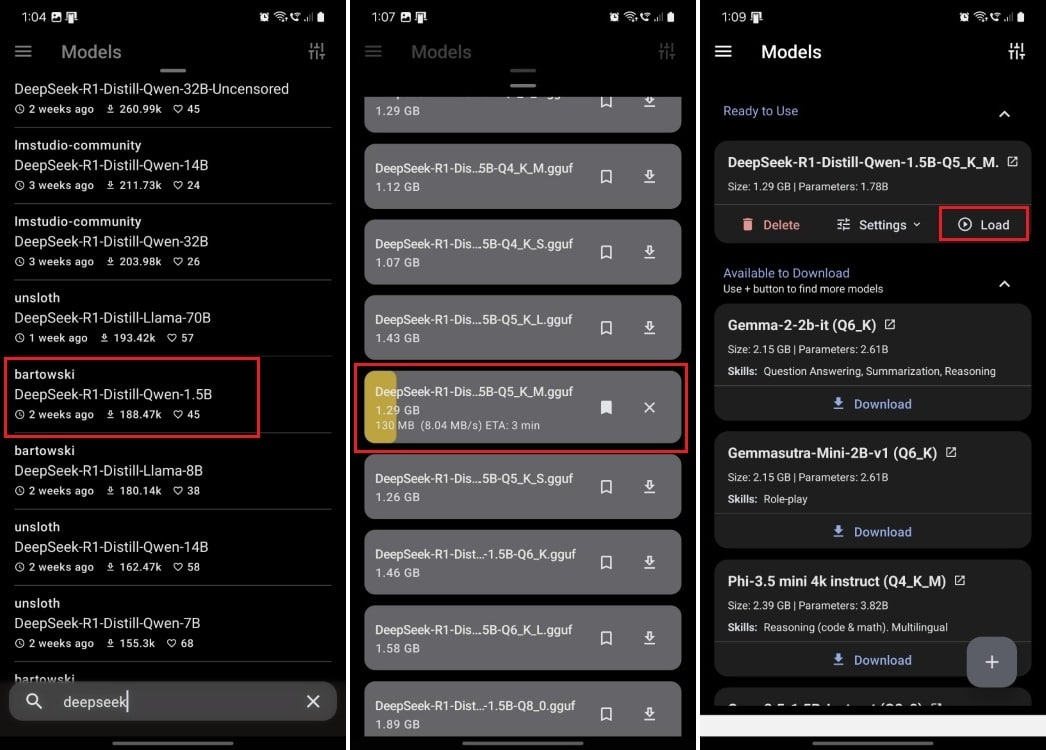
- Recherchez « deepseek » et faites défiler vers le bas pour trouver « DeepSeek-R1-Distill-Qwen-1.5B » par bartowski.
- Ouvrez-le et téléchargez le modèle approprié en fonction de la mémoire disponible sur votre téléphone. J'ai téléchargé le modèle quantifié « Q5_K_M » pour ce tutoriel car il consomme environ 1.3 Go de RAM.
- Après avoir téléchargé le formulaire, revenez en arrière et cliquez sur Télécharger.
- Vous pouvez désormais discuter localement avec le modèle DeepSeek R1 sur votre téléphone Android ou iPhone.
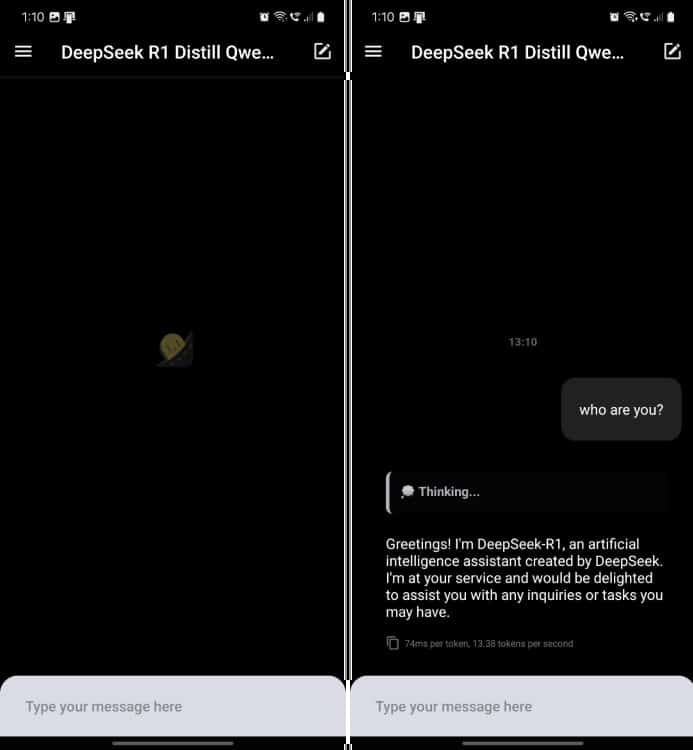
Voici les différentes manières d'installer DeepSeek R1 sur PC et Smartphone Discuter avec le modèle d'IA hors ligne. Lors de mes brefs tests, les modèles 1.5B et 7B ont montré de nombreuses hallucinations et erreurs historiques.
Cependant, vous pouvez facilement utiliser ces modèles pour l’écriture créative et le raisonnement mathématique. Si vous disposez d'un matériel puissant, je vous recommande d'essayer le modèle DeepSeek R1 32B. Il est bien meilleur en codage et en fourniture de réponses appuyées par la logique.