La plupart des outils d'IA que nous utilisons aujourd'hui fonctionnent sur le cloud, ce qui signifie qu'ils nécessitent une connexion internet constante. Bien qu'il existe des options pour exécuter des outils d'IA localement sur nos appareils, l'idée reçue est que cela nécessite du matériel puissant et coûteux.
C'est ce que je pensais aussi, jusqu'à ce que je décide de tester certains outils d'IA natifs sur une machine relativement ancienne – une carte graphique GTX 1070 datant de près de dix ans – et que je découvre que c'est possible et efficace. Cette expérience a ouvert la voie à de nouvelles possibilités d'utilisation de l'IA, même sur des appareils aux spécifications modestes, rendant cette technologie accessible à un plus large éventail d'utilisateurs.

Liens rapides
Pourquoi avez-vous besoin d’utiliser un chatbot IA local ?
J'ai utilisé d'innombrables chatbots en ligne basés sur l'IA, comme ChatGPT, Gemini, Claude et d'autres. Ils fonctionnent très bien. Mais qu'en est-il des moments où vous n'avez pas de connexion internet et souhaitez tout de même utiliser un chatbot basé sur l'IA ? Ou si vous souhaitez travailler sur un sujet très privé ou des informations qui ne peuvent être divulguées, que ce soit pour le travail ou pour d'autres raisons ?
C'est dans ce cas que vous avez besoin d'un modèle de langage étendu (LLM) local et hors ligne qui conserve toutes vos conversations et données sur votre appareil. Chatbot IA local Exploiter la puissance de l’intelligence artificielle sans dépendre d’une connexion Internet.
La confidentialité est prise en compte L’une des principales raisons d’utiliser un grand modèle de langue locale estMais il existe également d'autres raisons, telles que l'évitement de la censure, l'utilisation hors ligne, les économies de coûts, la personnalisation, etc. Il vous fournit Chatbot IA local Contrôle total sur vos données, garantissant que vos informations sensibles restent sûres et sécurisées.
Que sont les modèles de langage quantifiés à grande échelle (LLM quantifiés) ?
Le matériel constitue le principal défi pour la plupart des personnes souhaitant utiliser des modèles de langage volumineux (LLM) sur site. Les modèles d'IA les plus puissants nécessitent un matériel performant pour fonctionner. Outre la simplicité d'utilisation, les limitations matérielles expliquent également pourquoi la plupart des chatbots basés sur l'IA reposent sur le cloud computing.
Les limitations matérielles sont l'une des raisons pour lesquelles je pensais ne pas pouvoir exécuter un modèle de langage étendu (LLM) en natif. J'ai actuellement un PC assez modeste, équipé d'un processeur AMD Ryzen 5800x (lancé en 2020), de 32 Go de RAM DDR4 et d'un GPU GTX 1070 (lancé en 2016). Ce n'est donc pas du matériel haut de gamme, mais vu que je joue peu ces derniers temps (et quand je le fais), je choisis Jeux indépendants plus anciens et moins gourmands en ressources) et le coût élevé des GPU modernes, je suis content de ce que j'ai.
Cependant, il s’avère que vous n’avez pas besoin du modèle d’IA le plus puissant. Modèles de langage quantifiés à grande échelle (LLM quantifiés) Il s’agit de modèles d’IA qui ont été rendus plus petits et plus rapides en simplifiant les données qu’ils utilisent, en particulier les nombres avec un point décimal.
L'IA utilise généralement des nombres de haute précision (tels que des décimales 32 bits), qui consomment beaucoup de mémoire et de puissance de traitement. La quantification réduit ces nombres à des nombres de moindre précision (tels que des entiers 8 bits) sans modifier significativement le comportement du modèle. Ainsi, le modèle s'exécute plus rapidement, utilise moins d'espace de stockage et peut être exécuté sur des appareils plus petits (tels que des smartphones ou des périphériques), avec toutefois parfois une légère perte de précision.



Cela signifie que même si mon ancien matériel aurait certainement du mal à exécuter un grand modèle de langage (LLM) aussi puissant que le Llama 3.1 à 205 milliards de paramètres, il pourrait exécuter le modèle quantique plus petit de 8 B à la place.
Et quand OpenAI annoncé Pour mes premiers modèles d'inférence pondérés ouverts entièrement quantifiés, j'ai pensé qu'il était temps de voir à quel point ils fonctionnaient bien sur mon ancien matériel.
Comment utiliser un grand modèle de langage (LLM) localement avec une carte graphique Nvidia GTX 1070 et LM Studio ?
Je voudrais commencer cette section en précisant que je ne suis pas un expert des modèles locaux de langage à grande échelle (LLM), ni du logiciel que j'ai utilisé pour exécuter ce modèle intelligent sur ma machine. Je vais simplement présenter ici une description de ce que j'ai fait pour exécuter un chatbot intelligent localement sur ma carte graphique GTX 1070, ainsi qu'une évaluation de l'efficacité de cette solution. L'objectif est de démontrer comment exploiter la puissance de calcul disponible pour exécuter des modèles d'IA avancés sans avoir recours à des services cloud.
Télécharger LM Studio
Pour exécuter un modèle linguistique de grande taille (LLM) localement, vous avez besoin d'un logiciel spécialisé. Plus précisément, un programme Studio LM, un outil gratuit qui vous permet de télécharger et d'exécuter des modèles LLM localement sur votre appareil. Accédez à la page d'accueil de LM Studio et choisissez Télécharger pour [système d'exploitation] (J'utilise Windows 10.) LM Studio est une plateforme idéale pour les développeurs et les chercheurs qui souhaitent expérimenter différents grands modèles de langage et évaluer leurs performances sur leurs machines personnelles avant de les déployer.
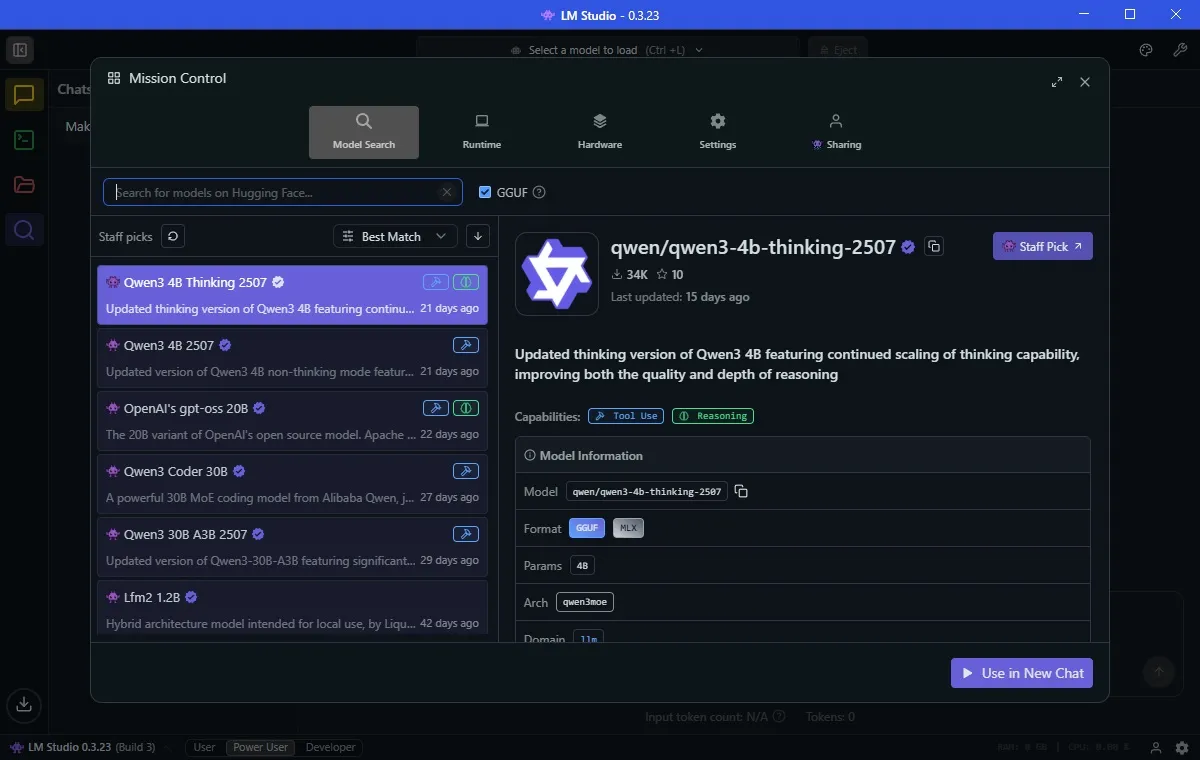
Il s'agit d'une procédure d'installation Windows standard. Exécutez le programme d'installation, terminez l'installation, puis lancez LM Studio. Je recommande de choisir l'option Power User Parce qu'il révèle des options utiles que vous pourriez vouloir explorer. Cette option offre un meilleur contrôle des paramètres du programme et des options avancées pour personnaliser l'expérience d'utilisation des modèles LLM. Avec LM Studio, vous pouvez explorer l'univers des grands modèles linguistiques facilement et efficacement.
Téléchargez votre premier modèle d'IA local
Après l'installation, vous pouvez charger votre premier grand modèle de langage (LLM). Sélectionnez l'onglet Découvrir (Icône de loupe). LM Studio affiche facilement les modèles d'IA natifs qui fonctionneront le mieux sur votre appareil.
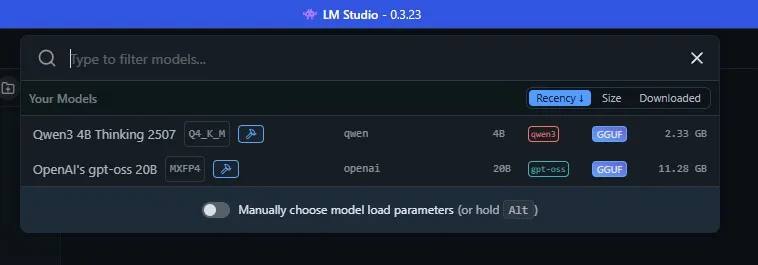
Dans mon cas, il suggère de télécharger un modèle nommé Qwen 3-4b-pensée-2507Le nom du modèle est Qwen (Développé par le géant technologique chinois Alibaba), qui est la troisième version de ce modèle. La valeur « 4b » signifie que ce modèle dispose de quatre milliards de paramètres pour vous répondre, tandis que « thinking » signifie que ce modèle prendra le temps de réfléchir à sa réponse avant de vous répondre. Enfin, la dernière mise à jour de ce modèle a eu lieu le 2507 juillet 25.
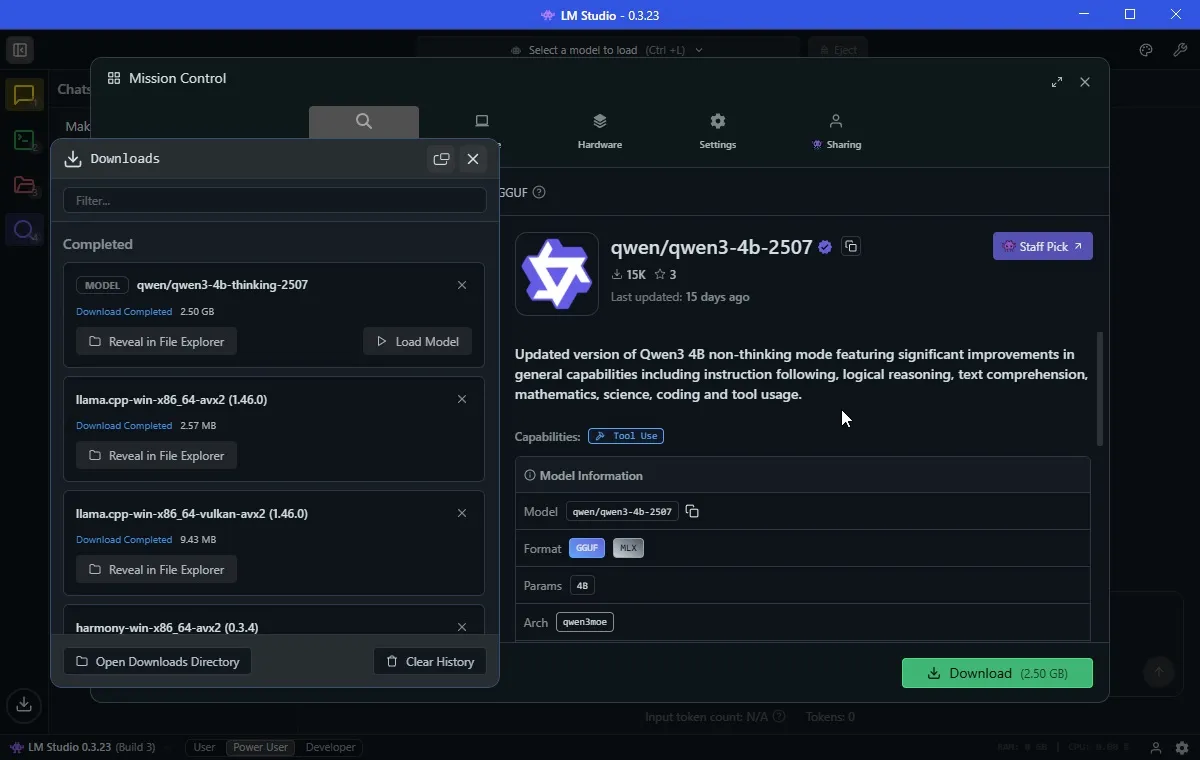
Qwen3-4b-thinking ne pèse que 2.5 Go, son téléchargement ne devrait donc pas prendre beaucoup de temps. J'ai également téléchargé OpenAI/gpt-oss-20b, plus volumineux (12.11 Go). Il comporte également 20 milliards de paramètres, ce qui devrait fournir de « meilleures » réponses, même si son coût en ressources sera plus élevé.
Maintenant, à part Les complexités de la dénomination des modèles d'IAUne fois que vous avez téléchargé LLM, vous êtes presque prêt à commencer à l'utiliser.
Avant d'exécuter le modèle d'IA, accédez à l'onglet Hardware Assurez-vous que LM Studio identifie correctement votre système. Vous pouvez également faire défiler vers le bas et ajuster. Filières Voilà. J'ai configuré les pare-feu de mon ordinateur pour Équilibré, empêchant tout modèle d'IA de consommer trop de ressources, ce qui pourrait entraîner une surcharge du système.
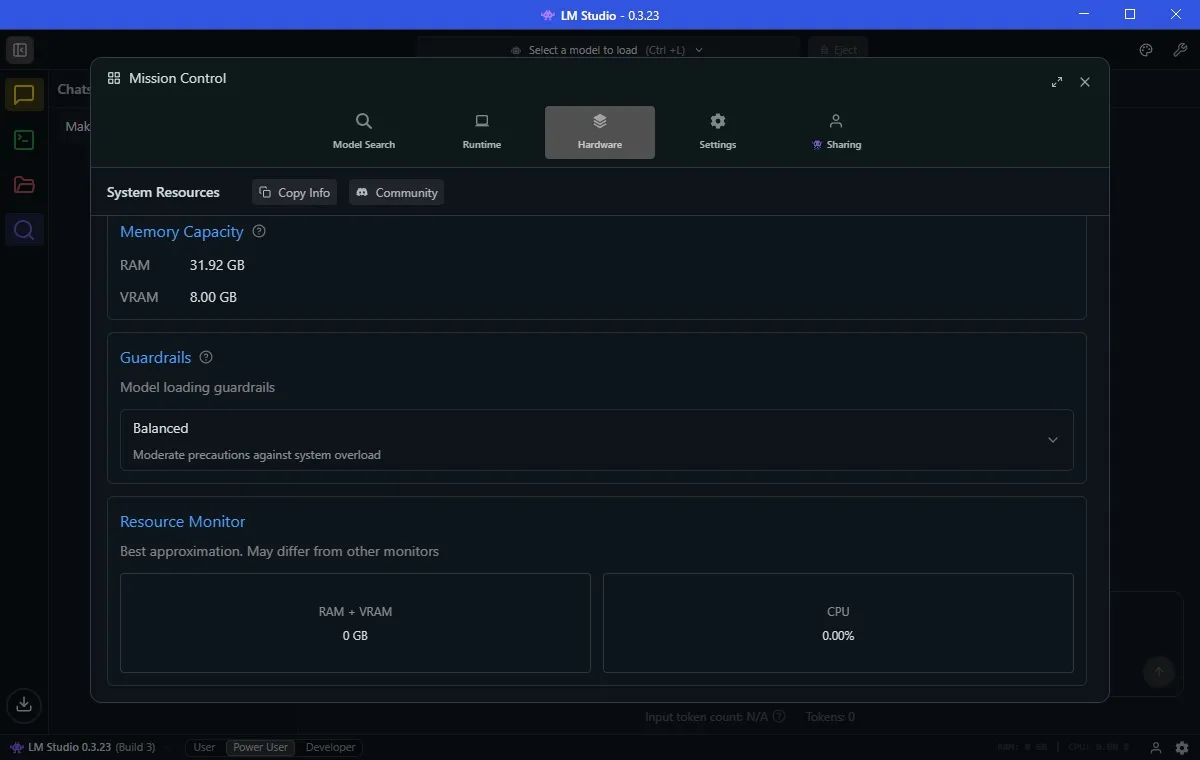
Vous remarquerez également Moniteur de ressources Sous les garde-fous. C'est un moyen simple de connaître l'utilisation système de votre modèle d'IA. Il est utile de surveiller cette situation si, comme moi, vous utilisez un matériel relativement limité, afin d'éviter tout plantage inattendu de votre système.
Téléchargez votre modèle d’IA et commencez à l’utiliser.
Vous êtes maintenant prêt à utiliser votre chatbot IA localement sur votre appareil. Dans LM Studio, sélectionnez la barre supérieure, qui fait office d'outil de recherche. Sélectionner le nom de l'IA chargera le modèle IA dans la mémoire de votre ordinateur et vous pourrez commencer à saisir des commandes et des questions. Ce processus est nécessaire pour activer les fonctionnalités du modèle de langage étendu (LLM) directement sur votre appareil, vous permettant ainsi d'expérimenter l'IA de manière interactive et rapide sans connexion internet permanente. N'oubliez pas que les performances du modèle dépendent des spécifications de votre appareil ; assurez-vous donc de disposer de ressources suffisantes pour exécuter efficacement votre modèle IA.
Exécuter un modèle d'IA localement sur du matériel ancien : génial, mais avec des limites
Exécuter un modèle d'IA localement vous permet d'en tirer profit de manière classique, mais il est important de connaître certaines limites importantes. Ces modèles locaux, bien qu'utiles, ne sont pas aussi puissants que les modèles de pointe comme GPT-5 utilisé dans ChatGPT. De plus, vous remarquerez que le processus de réflexion et de réponse est beaucoup plus long, et que la qualité des réponses peut varier considérablement.
À titre d'exemple, j'ai testé un modèle de langage classique (LLM) sur Qwen et gpt-oss, et tous deux ont réussi la tâche, malgré une longue attente. Cela démontre qu'utiliser un modèle d'IA natif sur une machine plus ancienne peut être une solution pratique, mais cela nécessite de la patience et une compréhension des limites du matériel ancien.
Allen, Bob, Colin, Dave et Emily forment un cercle. Allen est à la gauche de Bob. Bob est à la gauche de Colin. Colin est à la gauche de Dave. Dave est à la gauche d'Emily. Qui est à la droite d'Allen ?
Il a fallu 5 minutes et 11 secondes à Qwen pour parvenir à la bonne conclusion. GPT-5 n'a mis qu'environ 45 secondes. Mais qui a surpassé tout le monde ? gpt-oss-20b avec un temps record de 31 secondes.
Un seul test ne suffit pas, alors je l'ai testé sur un autre puzzle conçu pour tester les capacités de raisonnement de l'IA. Lors d'un test précédent, le dernier modèle d'OpenAI, GPT-5, avait échoué à ce test. J'étais donc impatient de voir comment les versions hors ligne de Qwen et gpt-oss s'en sortiraient.
Analyse des performances des modèles d'intelligence artificielle dans la résolution de problèmes logiques
La capacité à résoudre des problèmes logiques constitue un véritable défi pour les modèles d'IA. L'exemple ci-dessus, qui implique l'identification de relations spatiales entre un groupe de personnes, illustre la variabilité des performances de ces modèles.
Relations spatiales et défis de l'intelligence artificielle
Le traitement des relations spatiales est un élément fondamental de l'intelligence artificielle, nécessitant une compréhension fine du langage et la capacité de raisonner logiquement. L'exemple précédent montre que certains modèles, comme gpt-oss-20b, excellent dans cette tâche, tandis que d'autres, comme Qwen et GPT-5, mettent plus de temps à parvenir à la bonne solution.
L'importance des différents tests pour évaluer l'intelligence artificielle
Aucun test ne permet d'évaluer de manière exhaustive les capacités de l'IA. Il est nécessaire de réaliser divers tests couvrant différents aspects de l'intelligence, tels que le raisonnement logique, la compréhension du langage et la résolution de problèmes complexes. Cela permet une évaluation plus précise des capacités et des limites de chaque modèle.
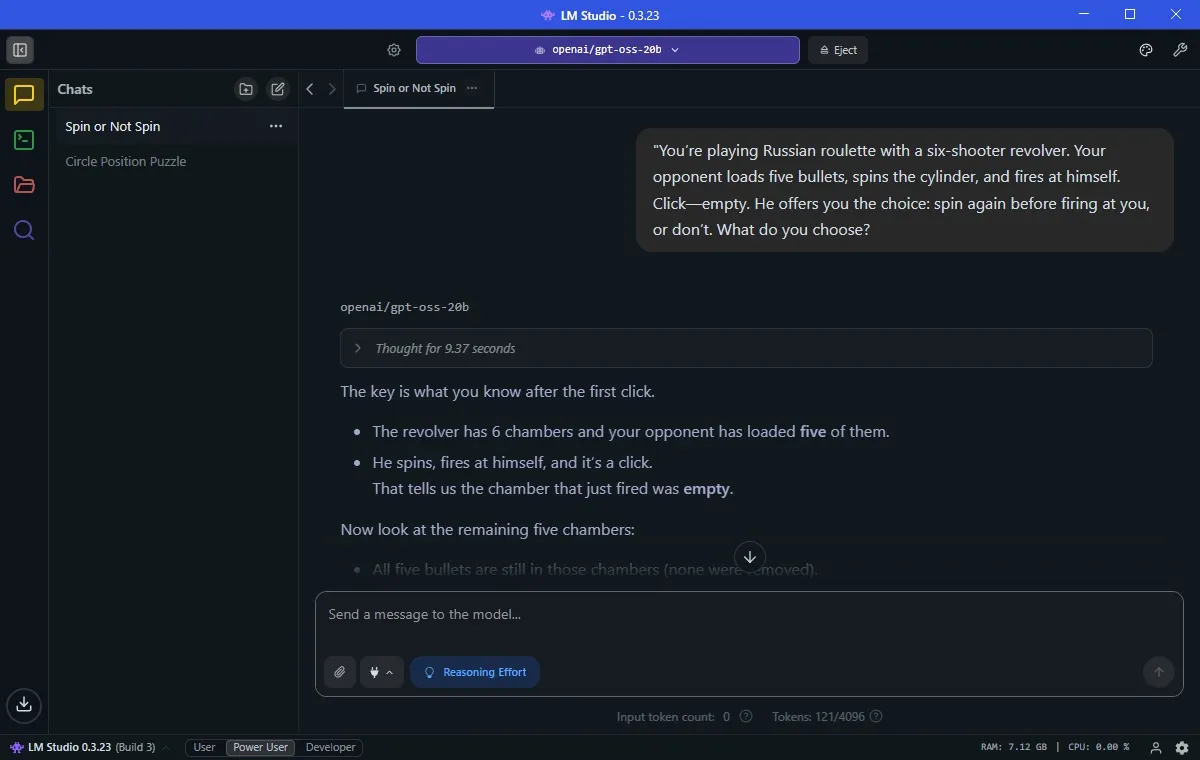
Imaginez que vous jouez à la roulette russe avec un pistolet à six coups. Votre adversaire charge cinq balles, fait tourner le tambour, puis se tire une balle. « Tic » signifie vide. Il vous propose alors un choix : voulez-vous faire tourner le tambour à nouveau avant de vous tirer dessus, ou non ? Que choisissez-vous ?
Le modèle Qwen a pu donner la bonne réponse en 41 minute et 5 secondes, ce qui est un excellent temps (compte tenu des limitations matérielles). Étonnamment, GPT-20 n'a pas réussi à résoudre ce problème, ce qui est vraiment surprenant. Il m'a même proposé de fournir un graphique expliquant pourquoi il avait raison. Une fois de plus, gpt-oss-9b a trouvé la bonne réponse en seulement XNUMX secondes.
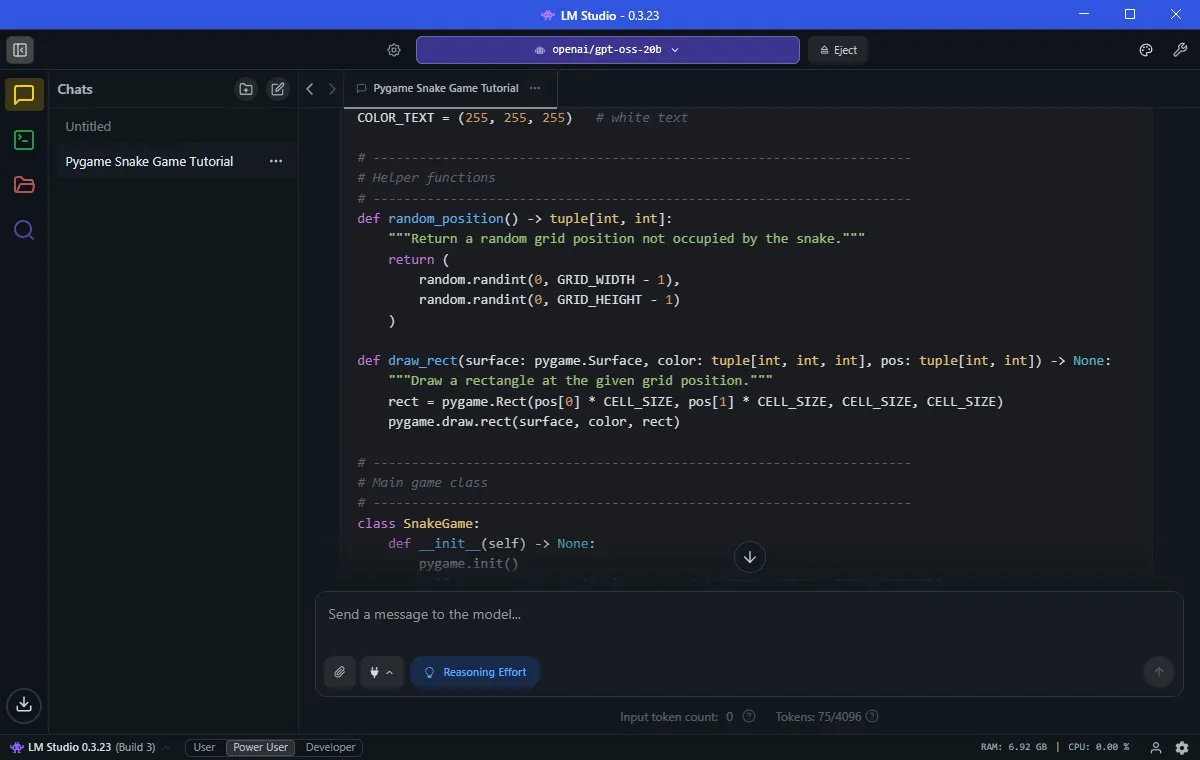
Dans d'autres domaines, j'ai également constaté un succès immédiat. J'ai demandé à gpt-oss de m'écrire un jeu de serpent avec Pygame et, en une minute ou deux, j'avais un jeu de serpent entièrement fonctionnel. Cela démontre la capacité du modèle à générer efficacement des jeux.
Exécuter un modèle d'IA sur vos anciens appareils
La clé pour exécuter un modèle de langage volumineux (LLM) en natif sur du matériel ancien est de choisir le modèle d'IA adapté à vos capacités. Si la version Qwen a donné de bons résultats et s'est avérée être le meilleur choix dans LM Studio, le modèle gpt-oss-20b d'OpenAI est clairement un choix bien supérieur.
Mais il est important de trouver un équilibre entre ses attentes. Même si gpt-oss a répondu aux questions avec précision (et plus rapidement que GPT-5), je ne pourrai pas lui fournir une quantité massive de données à traiter. Les limites de mon matériel apparaîtront rapidement.
Avant de l'essayer, j'étais convaincu qu'exécuter un chatbot d'IA natif sur mon ancien matériel était impossible. Mais grâce aux modèles quantiques et à des outils comme LM Studio, c'est non seulement possible, mais aussi étonnamment utile.
Cependant, vous n'obtiendrez pas la même vitesse, la même précision ni la même profondeur de raisonnement qu'avec un outil comme GPT-5 dans le cloud. L'exécution locale implique des compromis : vous gagnez en confidentialité, en accès hors ligne et en contrôle de vos données, mais vous perdez en performances.
Cependant, le fait qu'un GPU vieux de sept ans et un CPU vieux de quatre ans puissent gérer l'IA moderne est très prometteur. Si vous hésitez parce que vous ne disposez pas de matériel haut de gamme, pas d'inquiétude : les modèles quantiques locaux peuvent être la voie vers l'IA hors ligne. Utilisez le bon modèle d'IA pour tirer le meilleur parti de votre ancien matériel.